Уявіть: юридична фірма з 5 000 контрактів у Google Drive вирішила впровадити RAG-систему (Retrieval-Augmented Generation — технологію, яка дозволяє AI відповідати на запитання, спираючись на ваші власні документи). Підрядник отримав доступ, завантажив файли. Система запрацювала. А потім почалося: AI посилається на розірваний договір 2019 року замість чинного, не знаходить умови щодо форс-мажору, плутає клієнтів з однаковим прізвищем. Через місяць юристи перестали нею користуватися.
Причина провалу — не слабка модель і не поганий підрядник. Причина — документи ніхто не готував.
Підготовка документів займає до 40% загального обсягу RAG-проекту. Це найвищий ROI-фактор, який визначає, чи буде система корисною у щоденній роботі, чи перетвориться на дорогу іграшку. При цьому жоден технічний туторіал не пояснює цей процес з позиції власника бізнесу — лише з позиції розробника.
Ця стаття — покрокова інструкція для власника або операційного директора компанії 20–200 осіб: що потрібно зробити з вашими Word-файлами, PDF, Notion-сторінками і SharePoint-папками до того, як передати їх підряднику або власній команді для побудови RAG.
Чому «просто завантажити» не працює — реальна проблема корпоративних документів
Перше запитання, яке виникає у більшості керівників: «Навіщо щось готувати? Нехай AI сам розбереться». Це розумна інтуїція — сучасні мовні моделі справді вміють читати погано відформатований текст. Але RAG — це не просто читання. Це пошук по мільйонах фрагментів тексту, де від структури документа залежить, чи знайде система потрібну відповідь за секунду, чи поверне нісенітницю.
Типові джерела корпоративних документів
Перш ніж говорити про проблеми, визначимось, з чим зазвичай доводиться працювати. Типова компанія 50–150 осіб зберігає документи в кількох місцях одночасно:
- Google Drive або OneDrive — операційні документи, шаблони, таблиці Excel, презентації PowerPoint. Тут зазвичай найкраща ситуація з форматуванням, але документи часто не мають ніякої системи іменування.
- SharePoint — внутрішні регламенти, HR-процедури, технічні стандарти. Часто є ієрархія папок, але документи не оновлювалися роками.
- Notion або Confluence — вікі компанії, інструкції, онбординг. Структура є, але сторінки можуть бути незавершеними або містити застарілу інформацію.
- 1С або облікова система — звіти, накладні, специфікації. Зазвичай виходять у форматі PDF або Excel без чіткого тексту.
- Пошта та месенджери — неструктуровані обговорення, рішення «на ходу». Майже ніколи не підходять для RAG без значного редагування.
- Локальні папки на комп’ютерах — найгірший варіант. Документи є, але ніхто не знає що де лежить.
Усе це — ваша документальна база. І вона майже ніколи не буває «чистою» у технічному розумінні.
Що відбувається, коли погані документи потрапляють у RAG-систему
Симптоми поганої підготовки документів проявляються не одразу. Зазвичай на демо-версії система працює чудово — підрядник обрав найкращі документи для тестування. Проблеми починаються у перші тижні реальної роботи.
Симптом 1: Система відповідає застарілою інформацією. Наприклад, менеджер запитує про умови гарантії, а система посилається на регламент 2021 року, який уже три рази переписували. Причина — у базі є кілька версій одного документа, і RAG не знає, яка з них актуальна.
Симптом 2: AI «не знаходить» відповідь, яка точно є в документах. Клієнт запитує про конкретний пункт договору. Документ є в базі. Але система або каже «не знайдено», або дає розмиту відповідь. Причина — PDF був відсканований, а текст у ньому розпізнаний некоректно (символи переплуталися, абзаци злилися).
Симптом 3: Відповіді по таблицях завжди неправильні. Якщо ваші документи містять таблиці з цінами, нормами, специфікаціями — стандартний RAG обробляє їх як суцільний текст. Структура таблиці руйнується, і цифри втрачають контекст. Запитаєте «яка ціна на продукт X у 4-му кварталі?» — отримаєте число без жодної гарантії, що воно відповідає саме цьому продукту і саме цьому кварталу.
Симптом 4: Система плутає схожі поняття або документи. Є два контрагенти з однаковою назвою «ТОВ Алфа». Є регламент «Обслуговування клієнтів» і «Технічне обслуговування обладнання». Без чітких метаданих RAG не може розрізнити ці сутності й повертає змішану інформацію.
Все це — не баги в моделі. Це наслідки непідготовлених документів. І єдиний спосіб їх виправити — правильна підготовка ще до завантаження.
Крок 1 — Аудит і сортування документів перед обробкою
Перше, що треба зробити, — оцінити, з чим ви працюєте. Не всі документи однаково корисні для RAG, і витрачати однаковий ресурс на обробку чистого договору та відсканованої квитанції 1998 року — марнотратство.
Три категорії документів за «чистотою»
На основі enterprise-практики документи поділяються на три категорії, кожна з яких потребує окремого підходу:
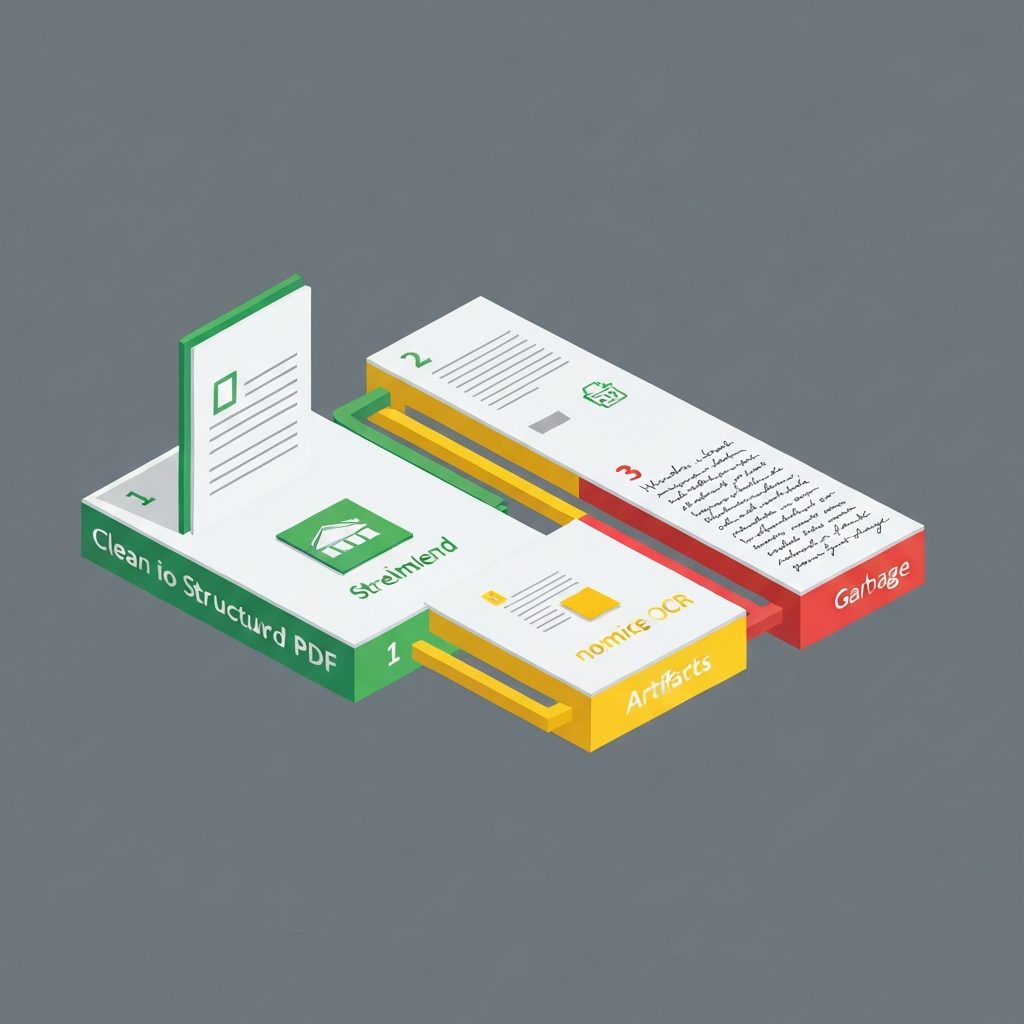
Категорія A — Чисті документи (повна обробка). Це файли з реальним текстовим шаром: Word-документи, Google Docs, правильно створені PDF (не відскановані), Notion/Confluence-сторінки. Текст у них машиночитаємий, структура зрозуміла. Вони йдуть у повний pipeline обробки — очищення форматування, ієрархічний chunking, детальні метадані.
Категорія B — Часткові документи (базова обробка з очищенням). PDF з невеликими OCR-артефактами (невірно розпізнані символи), презентації з мішаниною тексту і зображень, таблиці Excel у PDF-форматі. Ці документи можна обробити, але вони потребують додаткового кроку — автоматичного або ручного очищення.
Категорія C — Сміттєві документи (мінімальна обробка або відмова). Відскановані рукописні документи, PDF якісні 1990-х із жахливим OCR, файли де текст — це зображення без будь-якого розпізнавання. Для них або застосовують спеціалізований pipeline (дорогий), або встановлюють прапорець «потребує ручної перевірки» і включають у базу у мінімальному вигляді.
Важливо: не кожен документ категорії C треба обробляти. Якщо це скановані квитанції 15-річної давнини, які ніхто ніколи не шукатиме — краще їх просто виключити з бази. RAG-система, де 30% документів — шум, працює гірше, ніж система з меншою, але якіснішою базою.
Як виявити «сміттєві» файли: практичний чеклист
Пройдіться по вашій документальній базі і дайте відповіді:
- Чи можна виділити і скопіювати текст з PDF? (Якщо ні — це відскановане зображення)
- Чи є у документів назви, які відображають зміст? («Договір_оренди_ТОВ_Альфа_2024.pdf» — добре, «скан0045.pdf» — погано)
- Скільки версій одного документа є в базі? Чи є позначка «актуальний» / «архів»?
- Чи є в документах таблиці з критичною інформацією (цінами, нормами, термінами)?
- Чи є документи старші 5 років, які вже не відображають реальні процеси?
- Чи є дублікати — той самий документ в кількох папках?
Результат цього кроку — три списки файлів (A, B, C) і рішення по категорії C: обробляємо з прапорцем або виключаємо. Це займає від одного дня до тижня залежно від обсягу бази. Але саме це рішення дає більше покращення якості RAG, ніж будь-який апгрейд технічної моделі.
Крок 2 — Очищення документів: від сканів до структурованого тексту
Після сортування починається безпосередня підготовка документів. Для кожного типу файлів є свої особливості.
PDF-файли — три сценарії
PDF — найпоширеніший формат корпоративних документів і одночасно найпроблематичніший для RAG. Всередині «PDF» ховаються три принципово різні типи файлів:
Сценарій 1: Textual PDF (текстовий PDF). Створений з Word або іншої програми, містить реальний текстовий шар. Ви можете виділити текст у Adobe Reader. Це найкращий варіант — такий файл обробляється майже без додаткових зусиль. Але навіть тут є пастки: колонтитули, номери сторінок і водяні знаки потрапляють у витягнутий текст і «забруднюють» чанки. Перед обробкою їх треба видалити або вказати підряднику, що вони є.
Сценарій 2: Image-based PDF (відсканований PDF). Документ відсканований і збережений як набір зображень. Текст не виділяється. Для обробки потрібен OCR (Optical Character Recognition — розпізнавання тексту з зображень). Якість OCR залежить від якості сканування: якщо оригінал чіткий і мова стандартна — сучасні інструменти (наприклад, Google Document AI або Azure AI Document Intelligence) дають точність 95%+. Якщо документ старий, пожовклий або написаний від руки — точність падає до 60–70%, і без ручної перевірки такий текст краще не включати в базу.
Сценарій 3: Mixed PDF (змішаний PDF). Найпідступніший варіант. Частина сторінок — текстові, частина — відскановані. Таке часто буває з договорами, де основний текст друкований, а підписи й печатки — скановані. Або зі звітами, де текст — текстовий, але таблиці вставлені як зображення. Для таких файлів потрібна посторінкова обробка з автоматичним визначенням типу кожної сторінки.
Ваше завдання як власника бізнесу — ідентифікувати, які PDFи у вас якого типу, і повідомити підряднику. Не чекайте, що вони самі розберуться — вони розберуться, але це займе значно більше часу і коштуватиме дорожче.
Що робити з відсканованими документами
Якщо у вас є значна частина відсканованих документів (більше 20% бази), перед передачею підряднику варто пройти такий процес:
Крок A: Визначити пріоритет. Які відскановані документи справді потрібні користувачам? Накладні за 2010 рік — навряд чи. Статут компанії або ліцензії — так, навіть якщо їм 15 років.
Крок B: Перерахувати для OCR. Пріоритетні документи відправити на якісний OCR. Для цього підійде Google Drive (автоматичний OCR при завантаженні) або спеціалізований сервіс. Якщо документи конфіденційні — уточнюйте у підрядника про on-premise варіанти.
Крок C: Ручна перевірка вибірки. Після OCR перевірте 10–15% документів вручну. Зверніть увагу на числа (цифри — найчастіша помилка OCR), власні назви, специфічні терміни вашої галузі.
Крок D: Прапорці на неперевірені. Документи, які пройшли OCR але не перевірялися вручну, позначайте в метаданих: ocr_verified: false. Це дозволить системі або користувачу враховувати нижчу надійність відповідей по цих документах.
Word і Google Docs — форматування, яке ламає RAG
Здавалося б, Word-документи мають бути ідеальними для RAG — текст читаємий, структура є. Але є кілька типових проблем:
Псевдоструктура через пробіли. У корпоративних документах часто «заголовки» — це просто жирний текст або рядок із Caps Lock, а не справжній заголовок стилю H1/H2. Алгоритми chunking не розпізнають таку структуру і розбивають документ неправильно.
Таблиці в Word. Word-таблиці конвертуються в текст, де рядки йдуть один за одним без збереження структури колонок. Якщо у вас прайс-лист або специфікація у Word — про це треба попередити підрядника окремо.
Колонтитули і підвали. Якщо кожна сторінка починається з «ТОВ Ромашка, конфіденційно» і закінчується «Сторінка 3 з 47» — цей текст буде в кожному чанку. RAG-система почне «думати», що кожен фрагмент пов’язаний із конфіденційністю або нумерацією сторінок.
Вбудовані зображення зі схемами. Блок-схеми процесів, організаційні структури, архітектурні схеми — вони у Word зберігаються як зображення. Без спеціальної обробки RAG їх не «бачить».
Рішення для Word і Google Docs: перед передачею підряднику пройдіться по найважливіших документах і переконайтесь, що заголовки використовують реальні стилі (H1, H2, H3), а не просто жирний текст. Це одна з найпростіших і найефективніших речей, яку ваша команда може зробити самостійно без технічних знань.
Крок 3 — Стратегія chunking: як розбивати документи
Chunking — розбивання документа на фрагменти (чанки), кожен з яких буде збережений у векторній базі даних і потім знаходитися при пошуку. Розмір і спосіб розбивки напряму визначають якість відповідей.
Пояснити суть просто: уявіть, що ви розрізали книгу рецептів на картки. Якщо картка занадто маленька — на ній лише список інгредієнтів без способу приготування. Якщо занадто велика — одна картка містить три різні рецепти, і коли шукаєш «як зварити борщ», система дає картку, де є і борщ, і вареники, і голубці разом. Обидва варіанти дають погані відповіді.
Фіксований розмір — коли підходить і коли шкодить
Найпростіший підхід: розрізати документ на фрагменти по 500 токенів (токен ≈ 0,75 слова) з перекриттям 50–100 токенів між сусідніми фрагментами.
Коли підходить: для неструктурованих текстів без логічних розділів — наприклад, транскрипти розмов з клієнтами, листи підтримки, вільно написані нотатки.
Коли шкодить: для будь-якого структурованого документа. Якщо в документі є заголовки, розділи, пункти — фіксований розмір ріже по середині логічних одиниць. Пункт 3.2 договору може опинитися в одному чанку з кінцем пункту 3.1 і початком пункту 3.3. Запитаєте про умови пункту 3.2 — система поверне суміш трьох пунктів.
Ієрархічний chunking — найкращий вибір для структурованих документів
Ієрархічний chunking зберігає логічну структуру документа. Замість одного рівня фрагментів є кілька:
- Рівень документа: заголовок, тип, дата, автор — все що ідентифікує документ цілком
- Рівень розділу: наприклад, «Розділ 3: Умови оплати» — великий блок на 1 000–2 000 токенів
- Рівень абзацу: конкретний пункт або параграф на 200–400 токенів
- Рівень речення: для точних фактологічних запитів — конкретне твердження
Коли приходить запит, система спочатку шукає на рівні розділу («Умови оплати»), а потім «заглиблюється» до конкретного абзацу. Це дає набагато точніші відповіді на складні питання.
Для чого це важливо вам: якщо у ваших документах є чітка ієрархія (номери розділів, підрозділів, пунктів) — зберігайте її. Не «спрощуйте» документи перед передачею підряднику, видаляючи нумерацію. Ця структура — цінна інформація для системи.
Семантичний chunking — коли документ не має чіткої структури
Деякі корпоративні документи не мають ніякої формальної структури: вільний опис процесу, стаття в корпоративному блозі, опис продукту у довільній формі. Для таких документів застосовують семантичний chunking — розбивку на основі зміни теми, а не фіксованого розміру чи заголовків.
Алгоритм аналізує, де закінчується одна думка і починається інша, і робить розрив там. Це складніше технічно, але для неструктурованих текстів дає кращий результат.
Ваша роль: якщо у базі є значна частина неструктурованих текстів — повідомте підряднику. Це вплине на вибір інструментів і трудомісткість.
Як обробляти таблиці та графіки окремо від тексту
Це найважливіший підрозділ цього кроку, і його найчастіше ігнорують.
Таблиці з Excel або PDF — найкритичніша інформація у більшості корпоративних документів: прайси, нормативи, терміни, квартальні показники. І водночас — найгірше, що можна завантажити в стандартний RAG без підготовки.
Коли таблиця конвертується в текст, рядки йдуть один за одним: «Продукт А 1500 грн Продукт Б 2300 грн Продукт В 900 грн». RAG розбиває це на чанки по 500 токенів — і в одному чанку може опинитися кінець таблиці продуктів А і початок таблиці послуг. Запитаєте «скільки коштує продукт А?» — отримаєте «1500», але без гарантії, що це правильна таблиця і правильний рядок.
Правильний підхід до таблиць:
Прості таблиці (до 5 стовпців, зрозуміла структура) конвертуються в CSV-формат, де кожен рядок — окремий чанк з усіма стовпцями як контекстом. Наприклад: «Продукт: А, Ціна: 1500 грн, Категорія: основна, Дійсна з: 01.01.2026».
Складні таблиці (вкладені заголовки, об’єднані клітинки, ієрархія) потребують окремого підходу — dual embedding (подвійне векторне представлення): один вектор для структурованих даних (цифри, назви), інший для семантичного опису таблиці («Таблиця цін на продукти категорії А за перший квартал»).
Графіки і схеми взагалі не можна обробити звичайним текстовим RAG. Для них або пишуть текстовий опис вручну, або використовують мультимодальні моделі (VLM — Vision Language Models), які «бачать» зображення.
Ваша роль: перед стартом проекту зробіть список: де у вашій базі є таблиці з критичною бізнес-інформацією. Це одна з перших речей, про яку треба говорити з підрядником.
Крок 4 — Метадані: чому 40% зусиль варто вкладати саме сюди
Метадані — це структурована інформація про документ, яка зберігається окремо від тексту і дозволяє фільтрувати та ранжувати результати пошуку. Найпростіший аналог — теги і категорії у вашому електронному листуванні.
Коли хтось запитує RAG-систему «покажи умови оплати за договором з ТОВ Бета», система не просто шукає «умови оплати» по всіх документах. Вона спочатку фільтрує документи, де в метаданих вказано контрагент: ТОВ Бета і тип: договір, і вже серед них шукає «умови оплати». Результат — точний і швидкий.
Без метаданих система шукає по всьому масиву документів і знаходить усі згадки «умов оплати» у всіх договорах, листах, регламентах і презентаціях — і видає суміш.
Мінімальна metadata-схема (підходить будь-якому бізнесу)
Незалежно від галузі, кожен документ у RAG-базі має мати щонайменше такі поля:
| Поле | Приклад значення | Навіщо |
|---|---|---|
doc_type |
договір, регламент, інструкція, прайс | Фільтрація за типом |
version_date |
2025-03-15 | Пошук актуальної версії |
status |
актуальний / архів / чернетка | Виключення застарілих |
department |
юридичний, фінанси, HR | Доступ по відділах |
author |
Петренко І.В. | Відповідальний |
language |
uk / ru / en | Для мультимовних баз |
ocr_verified |
true / false | Надійність тексту |
Це мінімум. Без цих полів навіть ідеально очищений і розбитий документ буде давати хаотичні відповіді.
Зверніть особливу увагу на поле status. Якщо в базі є стара і нова версія регламенту — без цього поля система буде посилатися на обидві одночасно. Саме це найчастіше призводить до того, що «RAG відповідає застарілою інформацією» — документи без дати і статусу в метаданих. Рішення просте: додати поля version_date і status: [актуальний / архів] і пройтися по базі, проставивши ці значення.
Приклади domain-specific метаданих для типових UA-бізнесів
Мінімальна схема — це фундамент. Для реальної корисності потрібні галузеві поля, які відображають специфіку вашого бізнесу.
Юридична фірма:
doc_type: договір оренди
counterparty: ТОВ Горизонт
contract_number: 145/2024
signing_date: 2024-08-01
expiry_date: 2025-08-01
status: актуальний
matter_id: M-2024-089
practice_area: нерухомість
Чому matter_id і practice_area? Тому що юристи шукають не «всі договори», а «всі документи по справі M-2024-089» або «всі договори нерухомості, що закінчуються у 2025 році». Без цих полів система не може відповісти на такий запит точно — вона буде шукати по тексту і губитися у схожих назвах.
Виробниче підприємство:
doc_type: технічний регламент
product_line: профільна труба
article_number: ТР-2045
revision: 3.1
effective_date: 2025-01-01
department: виробничий
equipment_type: стан 250
status: актуальний
Для виробника критично мати revision (номер ревізії) і article_number (артикул або номер виробу). Без цього при запиті «яка температура термообробки для артикула ТР-2045?» система видасть відповіді з різних версій регламенту — і ви не знатимете, яка з них правильна.
Сервісна компанія (IT, консалтинг, бухгалтерський аутсорс):
doc_type: SOP (стандартна операційна процедура)
process_name: онбординг нового клієнта
department: проектний
client_segment: SMB / Enterprise
language: uk
version_date: 2025-04-10
status: актуальний
owner: Коваленко М.
Тут ключові поля — process_name і client_segment. Сервісна компанія часто має різні процедури для різних сегментів клієнтів, і без цих полів менеджер отримає змішані інструкції.
Чому не треба використовувати LLM для витягання метаданих
Перше що спадає на думку: «Нехай AI сам вичитає метадані з документів». Це логічна ідея, але практика показує — вона не працює надійно.
LLM (велика мовна модель) непослідовно витягає метадані: той самий тип документа в різних контекстах може отримати назви «договір підряду», «підрядний договір», «контракт», «угода». В результаті фільтр по doc_type: договір знаходить лише частину документів.
Значно краще працює простий підхід: список ключових слів на кожен тип метаданих. «Договір підряду», «договір про виконання робіт», «підрядний контракт» → усі ці варіанти відображаються в doc_type: договір підряду. Починайте з 100–200 термінів для вашого домену і розширюйте за запитами, які система не знаходить.
Ваше завдання: скласти словник термінів для кожного поля метаданих — не підряднику, а самостійно. Ви краще за будь-якого розробника знаєте, як у вашій компанії називаються документи, процеси і підрозділи.
Крок 5 — Фінальна перевірка перед завантаженням у векторну базу
Після очищення, встановлення стратегії chunking і заповнення метаданих залишається один важливий крок — перевірка на тестовій вибірці до повного завантаження.
Що перевірити у тестовому запиті
Попросіть підрядника завантажити у RAG 50–100 документів із різних категорій і типів, і самостійно задайте кілька запитів — тих, які будуть типовими для вашої команди у реальній роботі.
Перевіряйте за таким алгоритмом:
Запит 1 — Фактологічний: «Яка ціна на продукт X у чинному прайс-листі?» Відповідь має бути однозначною і з посиланням на конкретний документ з датою.
Запит 2 — Порівняльний: «Чим відрізняються умови договорів з контрагентом А і контрагентом Б?» Система має знайти обидва документи і порівняти конкретні пункти.
Запит 3 — По процедурі: «Як зробити X?» (де X — типова операційна задача). Відповідь має містити послідовні кроки з актуальної версії регламенту, не суміш кількох версій.
Запит 4 — По «старих» документах: «Яка версія регламенту Y є архівною?» Система має відповісти коректно, використовуючи поле status.
Якщо всі чотири типи запитів дають точні відповіді — база готова до повного завантаження. Якщо є проблеми — повертайтесь до відповідного кроку підготовки.
Червоні прапорці: коли зупинитись і повернутись до очищення
Є кілька ознак, які сигналізують: завантажувати ще рано.
Прапорець 1: Система цитує документи без дати або з датою «невідомо». Це означає, що поле version_date не заповнене або документ не мав дати. Зупиніться і допрацюйте метадані.
Прапорець 2: На один запит система дає суперечливі відповіді з різних документів без вказівки, яка актуальна. Причина — кілька версій одного документа без поля status. Виправте перед повним завантаженням.
Прапорець 3: Відповіді по таблицях явно неправильні (числа не відповідають реальним значенням). Потрібна додаткова обробка таблиць.
Прапорець 4: Запити іноземною мовою або з абревіатурами дають не ті документи. Метадані потребують розширення словника термінів.
Пам’ятайте: краще виявити ці проблеми на 100 документах, ніж на 5 000.
Скільки це займає і кому належить ця робота
Найчастіше запитання від власників після прочитання попередніх кроків: «І все це робить підрядник?» Відповідь: частково так, але без вашої участі проект зупиниться.
Типова трудомісткість на 500 документів
На основі реальних enterprise-впроваджень підготовка 500 змішаних корпоративних документів займає орієнтовно:
| Етап | Хто робить | Час |
|---|---|---|
| Аудит і сортування (A/B/C) | Команда клієнта | 1–3 дні |
| OCR і очищення PDFів категорії B | Підрядник або автоматично | 2–5 днів |
| Ручна перевірка OCR (вибірка) | Команда клієнта | 1–2 дні |
| Визначення стратегії chunking | Підрядник | 1 день |
| Розробка metadata-схеми | Спільно | 1–2 дні |
| Заповнення метаданих | Команда клієнта | 3–7 днів |
| Тестове завантаження і перевірка | Підрядник + команда клієнта | 2–3 дні |
| Разом | 2–4 тижні |
Це приблизні цифри для 500 «живих» корпоративних документів без критичної кількості відсканованих матеріалів. Якщо в базі 5 000 документів і 40% — відскановані — помножуйте на 5–10.
Чому так довго? Тому що більша частина цієї роботи — не технічна, а змістовна: хтось повинен вирішити, який статус у кожного документа, які поля метаданих релевантні, що видалити, що залишити. Ці рішення не може прийняти підрядник — тільки людина, яка розуміє бізнес.
Детальніше про те, куди потрапляють підготовлені документи, — у нашій статті про векторні бази даних для бізнесу.
Хто з команди клієнта має брати участь
Одна з найпоширеніших причин провалу RAG-проектів — відсутність відповідального з боку клієнта. Підрядник отримує доступ до Google Drive, починає завантажувати документи, натрапляє на питання («яка версія актуальна?», «цей файл видалити чи залишити?») — і не має до кого звернутись. В результаті система завантажується «як є» і дає погані результати.
Document owner — це роль, яку треба призначити до старту проекту. Ця людина:
- Розуміє структуру документальної бази компанії (де що лежить, чому, хто відповідальний)
- Може приймати рішення: що включити, що виключити, яка версія актуальна
- Має час: мінімум 50% робочого часу протягом першого місяця проекту
- Є посередником між підрядником і відповідальними за різні підрозділи
Хто це може бути? Зазвичай операційний директор, керівник відділу, або досвідчений адміністративний менеджер. Не розробник і не випадковий стажер.
Якщо у вас немає людини з достатнім часом і розумінням документальної бази — краще перенести RAG-проект, ніж запускати його без document owner. Без цієї ролі підрядник витратить утричі більше часу і все одно дасть гірший результат.
Якщо ваша компанія ще тільки розглядає впровадження RAG, прочитайте також нашу статтю про архітектуру RAG для бізнесу — вона допоможе зрозуміти загальну картину перед зануренням у деталі підготовки.
Висновок і наступний крок
Підготовка документів — це не технічний «передстарт», який підрядник робить автоматично. Це бізнес-рішення про те, яку інформацію ваша компанія вважає надійною, актуальною і цінною для AI-системи.
Ключові тези, які варто запам’ятати:
- Аудит перед завантаженням — сортуйте документи на три категорії за якістю. Сміттєві документи знижують якість всієї системи.
- PDF — не однорідний формат. Текстові, відскановані та змішані PDF потребують різної обробки.
- Chunking відповідає структурі документа. Ієрархічний підхід — найкращий для більшості корпоративних баз.
- Таблиці — окремий pipeline. Стандартний RAG без підготовки таблиць даватиме неправильні числа.
- Метадані — не технічна деталь, це бізнес-логіка. 40% зусиль проекту тут — найвищий ROI.
- Document owner — обов’язкова роль зі сторони клієнта. Без неї навіть найкращий підрядник не зробить систему, якою користуватимуться.
Де підготовка документів знаходиться у загальному RAG-проекті? Це перший і найважливіший етап після визначення цілей. Без нього всі наступні кроки — вибір моделі, налаштування retrieval, інтерфейс — будуть будуватись на хиткому фундаменті.
Якщо ви хочете зрозуміти, в якому стані ваша документальна база і що потрібно зробити перед RAG-проектом — ми проводимо безкоштовний AI-аудит. За 5 днів аналізуємо ваші основні джерела документів, визначаємо категорії за якістю і формуємо рекомендації по metadata-схемі для вашої галузі.
Часті питання
Що таке RAG простими словами?
RAG (Retrieval-Augmented Generation) — технологія, яка дозволяє AI-системі відповідати на запитання, спираючись на ваші власні документи, а не лише на загальні знання. Система знаходить релевантні фрагменти з вашої бази документів і використовує їх як контекст для відповіді. Це дозволяє AI «знати» те, що є у вашій компанії — контракти, регламенти, прайси — і відповідати точно, а не приблизно.
Скільки документів потрібно для запуску RAG?
Немає мінімального порогу. RAG може працювати з 50 документами і з 50 000. Але є практичне спостереження: система стає справді корисною, коли база покриває 80%+ запитань, які реально виникають у роботі команди. Це може бути 200 якісних актуальних документів або 2 000 — залежить від складності бізнесу. Якість завжди важливіша за кількість.
Чи потрібно готувати всі документи компанії, чи тільки частину?
Краще почати з мінімальної якісної бази, ніж завантажувати все підряд. Визначте 3–5 найчастіших типів запитань вашої команди (умови договорів, технічні специфікації, процедури) і зберіть документи, які відповідають на ці запитання. Решту можна додавати поступово, після того як система показала результат на першому пулі.
Чи можна завантажити документи в RAG без підготовки і подивитись, як вийде?
Технічно — так. Практично — це марнування ресурсів. Непідготовлена система дає настільки поганий результат, що команда швидко перестає нею користуватись. Потім або витрачається час на повторну підготовку і перезавантаження, або проект закривається. Краще зробити правильно одразу: аудит + базове очищення + мінімальна metadata-схема займають 2–3 тижні, але рятують місяці розчарувань.
Що таке chunking і чи треба мені в це заглиблюватись?
Chunking — це спосіб, яким документ розбивається на фрагменти для зберігання в базі. Вам не потрібно знати технічні деталі, але важливо розуміти наслідки: якщо підрядник вибере неправильну стратегію для вашого типу документів — система давати поганий результат. Ваше завдання — розповісти підряднику про структуру ваших документів (є заголовки? є таблиці? є кілька версій одного документа?) і перевірити тестові запити перед повним завантаженням.
Чому RAG іноді дає неправильні відповіді, навіть коли документ є в базі?
Є кілька причин. Перша — документ відсканований і OCR розпізнав текст з помилками. Друга — потрібна інформація у таблиці, яку стандартний chunking обробив неправильно. Третя — є кілька версій документа без метаданих про актуальність. Четверта — запит використовує інший термін, ніж той, що в документі (наприклад, «угода» замість «договір»). Більшість цих причин усувається правильною підготовкою документів. Детальніше про симптоми і причини — у статті чому RAG дає неправильні відповіді.
Чим RAG відрізняється від fine-tuning і коли що обирати?
RAG і fine-tuning — два різних підходи до того, щоб AI «знав» вашу специфічну інформацію. RAG — пошук у базі документів під час відповіді. Fine-tuning — навчання моделі на ваших даних. RAG краще підходить, коли документи часто оновлюються і потрібне посилання на джерело. Fine-tuning краще, коли потрібен особливий стиль або вузькоспеціалізована термінологія без прив’язки до конкретних документів. Детальне порівняння — у статті RAG vs fine-tuning для бізнесу.