CTO отримав бюджет на RAG. Вибрав GPT-4o, найняв ML-інженера, запустив пілот на 500 документах — усе чудово. Retrieval точний, відповіді розумні, демо проходить без єдиної помилки. Потім виклали в production 30 000 документів SharePoint 2008 року — і система перестала знаходити нічого корисного.
Це не проблема моделі. Це 80% роботи, яку ніхто не показав у туторіалі.
Матеріал цієї статті базується на агрегованому досвіді 10+ enterprise-впроваджень RAG у регульованих галузях: фармацевтика, банківський сектор, юридичні фірми та консалтинг. Компанії від 100 до 1000 співробітників, корпуси від 10 000 до 50 000+ документів. Жоден з цих проектів не провалився через погану модель. Усі провали мали один корінь — недооцінка того, скільки саме engineering стоїть між вашими документами і якісним retrieval.
Якщо ви ще не знайомі з базовою архітектурою RAG, рекомендуємо почати з нашого огляду RAG для бізнесу: що це і навіщо. Ця стаття — наступний рівень: для тих, хто вже вирішив будувати і хоче розуміти, де справжні ризики і на що розподіляти бюджет.
Що насправді ламає enterprise RAG — і чому не модель
Три класи провалів у production: документи, метадані, інфраструктура
Коли enterprise RAG-система перестає давати корисні відповіді, запрошений консультант зазвичай отримує одне й те саме пояснення: «мабуть, модель слабка» або «нам треба кращий embedding». Після 10+ проектів можна сказати впевнено: ця діагностика хибна у переважній більшості випадків.
Реальні провали розподіляються на три категорії.
Провали документів. Система отримує документи з критичними проблемами якості — сканований рукопис 1995 року, PDF зі зламаним OCR, звіти на 500 сторінок із таблицями, які система читає як суцільний текст. Одна стратегія chunking для всього корпусу — і retrieval повертає нісенітницю.
Провали метаданих. Документи оброблені, але без доменно-специфічної metadata-схеми. Запит «педіатричне дослідження фазу 2» повертає набір документів, де слово «пацієнти» є, але вікова група, тип дослідження і регуляторна категорія не відфільтровані. Модель бачить схожий текст — але не ті документи.
Провали інфраструктури. Система чудово відповідає при одному одночасному користувачі на тестовому середовищі. У production з 50 паралельними запитами GPU-пам’ять переповнюється, queue не керується, latency стає неприйнятною, і клієнти отримують таймаути.
Чому пілот на 500 документах завжди успішний — і чому production на 30 000 ні
Туторіали і PoC-демо будуються на чистих документах. Зазвичай це PDF з нормальним OCR, однотипна структура, обсяг 100–500 сторінок. У цих умовах найпростіший підхід — fixed-size chunking по 512 токенів із overlap — дає прийнятні результати.
Корпоративна реальність виглядає інакше. Типова база документів середньої фармацевтичної компанії в Україні або ЄС містить одночасно: сканований паперовий архів 1990-х, сучасні PDF з клінічними звітами на 300–500 сторінок, Excel-таблиці з фінансовими показниками, які хтось конвертував у PDF, і регуляторні документи з перехресними посиланнями між десятками файлів.
Пілот проходить на вишнятих 500 документах. Production — на всьому корпусі.
Це не проблема масштабу. Це проблема гетерогенності. І вона не вирішується вибором кращої моделі.
Реальна статистика: 40% часу розробки → metadata-схеми. Це і є ROI
У практиці enterprise-впроваджень одна цифра стабільно повторюється: близько 40% загального часу розробки витрачається на проектування і наповнення metadata-схем.
Цю цифру часто сприймають як сигнал неефективності — «хіба не можна автоматизувати?». Насправді це найкращі 40% інвестиції в проект, з найвищим ROI з усього зробленого.
Як один з практиків, що пройшов через ці проекти, точно сформулював:
«Spent 40% of my development time on metadata and it had the highest ROI of anything I built.» «40% мого часу розробки пішло на метадані — і це дало найвищу віддачу з усього, що я зробив.»
Далі ми розберемо чому — і як це виглядає в конкретних галузевих схемах.
Документи — перший і найбільший ворог enterprise RAG
«Корпоративний PDF» — це не документ, це катастрофа для chunking
Коли розробник RAG-системи чує «у нас є PDF-архів», він уявляє один тип документа. Насправді «PDF» у корпоративному середовищі — це ціла зоопарку форматів:
- Рідний PDF (текстовий шар є) — обробляється нормально
- PDF із зображень (скан із OCR) — залежить від якості OCR
- PDF зі зламаним OCR — символи розпізнані, але рядки переплутані, таблиці «розсипані»
- PDF з вбудованими зображеннями таблиць — таблиці взагалі не розпізнаються стандартним парсером
- PDF із захистом або нестандартним шрифтом — парсер або не читає, або повертає кракозябри
Стандартний chunking-алгоритм отримує весь цей різношерстий матеріал і ріже його рівними шматками по 512 токенів. У результаті в один chunk потрапляє рядок із таблиці, половина заголовку та OCR-артефакти з наступного абзацу. Модель отримує цей «документ» і намагається знайти в ньому релевантний контент — безуспішно.
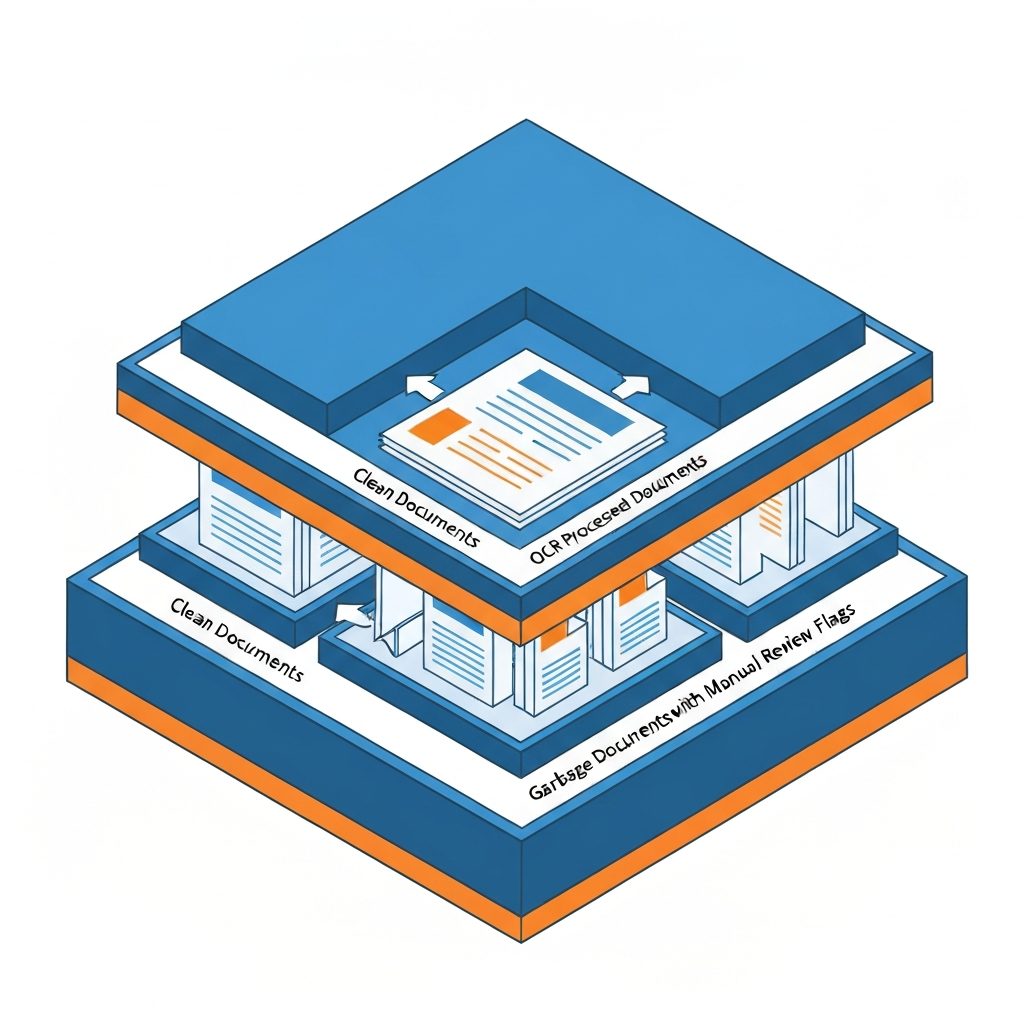
Система оцінки якості документів перед обробкою — три класи
Рішення, яке на практиці дає більше покращень retrieval, ніж будь-який апгрейд embedding-моделі: класифікувати документи за якістю перед тим, як взагалі починати їх обробляти.
Три класи документів — три різні pipeline:
Clean PDFs (текстовий шар якісний, структура зчитується). Повна ієрархічна обробка: document level → section level → paragraph level → sentence level. Таблиці витягуються окремо зі своїм pipeline.
Decent docs (присутні OCR-артефакти, але документ читабельний). Базовий chunking із попереднім кроком очищення: видалення зайвих символів, нормалізація пробілів, реконструкція порушених рядків. Метадані витягуються там, де вони достовірні.
Garbage docs (сканований рукопис, критично погана якість OCR, нечитабельна структура). Fixed chunks із збереженням мінімального контексту + автоматичний прапорець «потребує ручної перевірки». Такі документи не виключаються з бази — але система чесно сигналізує про низьку довіру до відповідей, що базуються на них.
Ця класифікація робиться до основної обробки і дає систему, яка «знає» про якість власних джерел. Це принципово важливо для enterprise, де частина документів може бути десятиліть давнини.
Ієрархічний chunking проти «512 токенів з overlap» із туторіалу
Туторіали пропонують просте рішення: ріжте документи по 512 токенів з overlap 50–100 токенів. Це працює для гомогенних корпусів з однотипними документами. Для enterprise-корпусу зі структурованими звітами — ні.
Ієрархічний chunking зберігає структуру документа:
- Document level: заголовок, автори, дата, тип документа, версія
- Section level: назва розділу (Abstract, Methods, Results, Appendix), номер сторінки
- Paragraph level: основний content chunk, 200–400 токенів
- Sentence level: для точних запитів, де потрібна конкретна цифра або формулювання
Ключовий принцип: рівень retrieval визначається складністю запиту. Загальне питання типу «які ризики препарату X?» → paragraph level. Точний запит «яке дозування вказано в таблиці 3?» → sentence level. Якщо confidence після paragraph-level retrieval низький — система автоматично «заглиблюється» до наступного рівня.
Ця логіка неможлива при fixed-size chunking — бо там немає структурних рівнів, тільки шматки тексту.
Таблиці як окремий pipeline — чому стандартний підхід ламається на цифрах
Таблиці — найцінніша частина корпоративних документів і найскладніша для стандартного RAG.
Фінансова звітність: точні числа по кварталах і сегментах. Клінічні дослідження: дозування, ефективність, побічні ефекти з розбивкою по когортах. Compliance-матриці: відповідність кожної вимоги регулятора конкретному документу. Саме там — відповіді на найважливіші питання клієнтів.
Стандартний парсер PDF або ігнорує таблиці (якщо вони у вигляді зображення), або читає їх як лінійний текст — втрачаючи всі зв’язки між рядками і стовпцями. Запит «яка виручка по сегменту B2B за Q3 2024?» в результаті отримує набір цифр без контексту до якого рядка і стовпця вони належать.
Рішення — окремий pipeline для таблиць:
- Виявлення таблиць евристиками (spacing patterns, grid structures) ще на рівні document scanning
- Прості таблиці → конвертація у CSV з повним збереженням структури
- Складні таблиці (вкладені, з merged cells, з ієрархічними заголовками) → збереження зв’язків у метаданих
- Dual embedding: структурований варіант (для точних числових запитів) + семантичний опис (для контекстного пошуку)
- Відстеження зв’язків між summary tables і detailed breakdowns у метаданих
Для фінансових компаній і фармацевтики цей pipeline часто є ключовою частиною цінності системи — без нього RAG буквально «не бачить» найважливішу інформацію.
Metadata — недооцінений CTO-важіль з найвищим ROI
Чому «погані метадані = поганий retrieval» незалежно від якості моделі
Metadata у RAG-системі — це не просто «теги» до документів. Це механізм, який дозволяє системі звузити простір пошуку перед семантичним retrieval.
Без метаданих запит «вимоги до клінічного дослідження фази 2 для педіатричних пацієнтів» запускає семантичний пошук по всьому корпусу. Система знаходить документи, де «пацієнти», «дослідження», «вимоги» є — але без фільтрації за типом документа, популяцією, регуляторною категорією. Шум у результатах зашкалює.
З правильними метаданими той самий запит спочатку фільтрує: тип документа = «клінічний протокол», регуляторна категорія = «EMA/FDA Phase 2», вікова група = «pediatric». Семантичний пошук відбувається вже в цьому вузькому підпросторі — з незрівнянно кращою точністю.
Це пояснює ROI метаданих: вони підвищують precision retrieval системно, для всіх запитів, незалежно від моделі.
Domain-specific metadata-схеми: фарма, фінанси, юридична сфера
Загальна metadata-схема (назва, дата, автор, тип файлу) не дає галузевої цінності. Потрібні доменно-специфічні схеми.
Фармацевтична компанія в Україні або ЄС: – Тип документа: клінічний протокол / SOP / regulatory submission / drug interaction report – Класифікація препарату (ATC-код або терапевтична область) – Демографія пацієнтів: вік, стать, co-morbidities – Регуляторна категорія: EMA / FDA / ВООЗ / локальний регулятор – Фаза дослідження: Phase 1 / Phase 2 / Phase 3 / post-market – Статус документа: актуальний / архівний / відкликаний
Фінансова компанія або банк: – Часовий період: квартал, рік, фінансовий рік – Тип документа: due diligence / compliance matrix / фінансова модель / аудиторський звіт – Бізнес-сегмент і географія – Клієнт або контрагент (з доступом на основі ролей) – Рівень конфіденційності: public / internal / confidential / restricted
Компанія з кадрового аутсорсингу або HR-відділ: – Тип документа: трудовий договір / NDA / оцінювання / HR-політика – Юрисдикція: країна/регіон дії документа – Статус: активний / архівний / на підпис – Рівень доступу: HR-only / менеджмент / загальний
Ці схеми не є загальновідомими — їх потрібно проектувати разом з доменними експертами клієнта. Саме тому 40% часу розробки йде на метадані: це не технічна задача, це аналітична.
Чому не варто витягувати метадані через LLM — і що працює замість
Перший інстинкт — автоматично витягувати метадані через LLM: «промт документа → список метаданих». Це не працює надійно в enterprise-масштабі.
LLM непослідовні у категоризації: той самий тип документа може бути класифікований по-різному залежно від формулювань у конкретному PDF. При 30 000 документів ця непослідовність накопичується і руйнує цінність metadata-фільтрації.
Що дійсно працює краще — keyword matching по domain-specific базі термінів. Принцип простий: для фармацевтичного домену — база з 100–200 ключових термінів і їх маппінг до полів схеми. «Phase II clinical study» → фаза: 2. «Pediatric patients aged 6-12» → вікова група: pediatric. «FDA submission» → регулятор: FDA.
Починати варто з 100–200 термінів і розширювати список на основі реальних запитів, які не матчаться правильно. За 2–3 ітерації coverage стає достатнім для надійної фільтрації.
Failure mode: acronym confusion та cross-reference chains у спеціалізованих доменах
Семантичний пошук має системний failure mode у спеціалізованих галузях: омоніми і перехресні посилання.
Acronym confusion. У онкологічних документах «CAR» — це «Chimeric Antigen Receptor». У радіологічних — «Computer Aided Radiology». Обидва акроніми мають ідентичне або дуже близьке embedding — модель не розрізняє контекст. У практиці це призводить до 15–20% failure rate семантичного пошуку у фармацевтичних і юридичних корпусах — значно вище, ніж стандартні оцінки у 5%.
Рішення — context-aware acronym expansion: база акронімів з галузевим контекстом, яка підставляє розгорнуту форму перед embedding.
Cross-reference chains. Регуляторні документи фармацевтичної компанії будуються на ланцюжках посилань: FDA guidelines → клінічні дослідження → drug interaction papers. Стандартний RAG обробляє кожен документ ізольовано — ці зв’язки невидимі.
Рішення — graph layer, який відстежує перехресні посилання під час початкової обробки документів. Після semantic retrieval система перевіряє чи є пов’язані документи, що містять кращу або уточнюючу відповідь. Це особливо критично для регуляторного комплаєнсу, де відповідь без посилання на базовий документ-джерело юридично нерелевантна.
Data sovereignty — чому open-source LLM стає enterprise-стандартом
Хто не може відправляти дані до OpenAI API — і що з цим робити
Питання «хмара або on-premise?» у більшості туторіалів подається як питання вартості. Для регульованих галузей це питання юридичної відповідності.
Фармацевтична компанія не може відправляти клінічні дані пацієнтів на зовнішній API — ні до OpenAI, ні до Azure OpenAI без окремого DPA і оцінки GDPR. Банк не може відправляти дані due diligence або compliance-документи про клієнтів. Юридична фірма не може відправляти конфіденційні матеріали справ.
Це не параноя — це GDPR, HIPAA (якщо є EU-клієнти або партнери), галузеві регуляції НБУ і ДССЗІ для фінансового сектору. Порушення — штрафи, втрата ліцензій, відповідальність.
Детальніше про технічні аспекти захисту даних у AI-системах — у нашій статті про privacy і AI-захист даних клієнтів.
Висновок для CTO: якщо ваша компанія у регульованій галузі або обробляє конфіденційні дані клієнтів — on-premise не варіант, це вимога.
Qwen QWQ-32B on-premise: реальні параметри і порівняння вартості з GPT-4o
Ще 2–3 роки тому on-premise LLM означав суттєвий компроміс у якості порівняно з GPT-4o. Зараз це вже не так.
Qwen QWQ-32B після domain fine-tuning демонструє якість, достатню для переважної більшості enterprise-задач retrieval і відповідей на документи. При цьому різниця у вартості при high-volume обробці — близько 85% на користь on-premise варіанту порівняно з GPT-4o API.
Для корпусу 50 000 документів і тисяч запитів на день ця різниця перетворюється на суттєву суму щомісяця. При on-premise: одноразові витрати на GPU-інфраструктуру + обслуговування. При API: постійні операційні витрати, що ростуть разом із навантаженням.
Ще одна перевага — відсутність rate limits. API-провайдери обмежують кількість запитів за часовий інтервал. Для enterprise-системи, де 50 аналітиків одночасно роблять запити у пікові години, це практична проблема. On-premise модель відповідає з постійним response time, обмеженим тільки GPU-потужністю.
GPU-питання: яке залізо потрібне і де є підводні камені бюджетування
Для on-premise deployment Qwen QWQ-32B у quantized 4-bit форматі потрібно 24 GB VRAM. Це одна RTX 4090 — технічно можливо.
Але RTX 4090 не вирішує задачу concurrent users у enterprise-масштабі. При 20–50 одночасних запитах GPU-пам’ять переповнюється, система уповільнюється або падає. Для enterprise з реальним навантаженням потрібні A100 або H100.
Тут є стандартний підводний камінь бюджетування: клієнти бачать ціну GPU і відчувають опір — навіть якщо загальний бюджет проекту значний. Причина — GPU купується з капітального бюджету, з амортизацією, і вимагає окремого затвердження. Це інший процес, ніж операційні витрати на API.
Практичний шлях: перед початком проекту з’ясуйте, чи є у компанії невикористаний GPU-compute від попередніх data science ініціатив. У більшості enterprise-клієнтів він є — і часто доступний без нових капітальних витрат.
Hybrid retrieval як обов’язковий стандарт у регульованих галузях
Чистий семантичний пошук недостатній для enterprise — не через слабкість моделей, а через природу запитів у регульованих галузях.
Hybrid retrieval поєднує три шари:
Semantic search — основний шар для контекстних запитів («які ризики взаємодії препарату X з Y?»).
Keyword triggers — для точних запитів, де потрібне конкретне число або формулювання («яке дозування в таблиці 3?»). При виявленні таких патернів система перемикається на rule-based retrieval, який шукає точний match, а не семантично схоже.
Graph layer — для запитів, що вимагають прослідкування ланцюжка посилань між документами. Особливо критично для compliance-задач, де відповідь вимагає підтвердження з первинного нормативного документа.
Для регульованих галузей hybrid retrieval — не опціональне покращення, а архітектурна вимога. Без нього система або пропускає критичну інформацію (в таблицях і точних посиланнях), або видає відповіді з неправильних джерел.
Production-реальність: concurrent users, uptime і resource management
Чого немає у туторіалах і що є в production
Туторіали демонструють систему в ідеальних умовах: один запит, обмежений корпус, необмежені ресурси. Production — це паралельні запити, неоднорідні документи, SLA, моніторинг і відновлення після збоїв.
Конкретні виклики, які виникають у production і яких немає у жодному туторіалі:
- Cold start після перезапуску. Завантаження моделі займає час. Перший запит після cold start у продакшн-системі не може чекати 2–5 хвилин. Потрібні warm-up процедури і health checks.
- Graceful degradation при перевантаженні. Коли GPU-пам’ять наближається до ліміту, система не повинна «падати» — вона має відповісти з коротшим контекстом або попередженням про обмежену надійність відповіді.
- Audit trails для compliance. У регульованих галузях кожен запит і відповідь мають логуватися — хто запитував, коли, які документи були retriev-нуті, яка була відповідь. Це вимога аудиторів, а не «nice to have».
GPU memory management і semaphores при паралельних запитах
Найбільший production-виклик — resource contention при паралельних запитах.
Типова ситуація: 50 аналітиків одночасно роблять запити після обідньої наради. Кожен запит вимагає завантаження контексту в GPU-пам’ять. Без управління ресурсами система намагається обробити всі 50 запитів одночасно, пам’ять закінчується, і вся система зависає або падає.
Рішення — semaphores + queue management:
- Semaphore обмежує кількість одночасних запитів до GPU (зазвичай 5–10 залежно від конфігурації)
- Решта запитів ставляться у чергу з пріоритизацією
- Користувач бачить «запит обробляється» з оцінкою часу очікування, а не таймаут
- Окрема черга для background tasks (нові документи, переіндексація) з нижчим пріоритетом
Це стандартна інженерна задача — але її треба вирішувати явно. У жодному RAG-туторіалі ця тема не з’являється, бо вона несексуальна з ML-точки зору. Але саме вона визначає чи буде система використовуватися реальними користувачами.
Надійність більша за fancy features — що клієнти цінують насправді
Після 10+ enterprise-впроваджень один висновок повторюється без виключень. Як точно формулює практичний досвід:
«Clients care more about reliability than fancy features. Resource management and uptime matter more than model sophistication.» «Клієнти цінують надійність більше за складні функції. Управління ресурсами і uptime важливіші за витонченість моделі.»
CTO, який замовляє RAG-систему, отримує тиск знизу — від кінцевих користувачів. Якщо аналітик запитує систему 10 разів на день, а 2 з 10 запитів дають таймаут або безглузду відповідь, — він повертається до ручного пошуку. Система формально «впроваджена», але не використовується.
Надійна система з 85% точністю і стабільним uptime дає більше бізнес-цінності, ніж система з 95% точністю але 20% таймаутів. Це не компроміс — це правильна інженерна пріоритизація.
Реалістичний roadmap для CTO без власної AI-команди
Більшість матеріалів про enterprise RAG написані з розрахунку на компанію, що має ML-команду. Для компаній 50–500 осіб без дедикованого AI-відділу потрібен інший підхід: де мінімальне залучення внутрішніх ресурсів, де критична участь, де ризик-точки.
Фаза 1 — тижні 1–2: аудит документів і класифікація якості
Перш ніж писати рядок коду — зрозумійте що у вас є.
Задачі цієї фази: – Інвентаризація документального корпусу: де зберігається, скільки файлів, формати, вік – Document quality audit: sample 200–300 документів, класифікувати за трьома класами (clean / decent / garbage), оцінити відсоток кожної категорії – Виявлення «прихованих таблиць»: скільки критичної інформації знаходиться в таблицях PDF, які стандартний парсер не читає – Інтерв’ю з 5–10 кінцевими користувачами: які типи запитів найчастіші, де зараз найбільший bottleneck у пошуку
Результат фази: технічний звіт з оцінкою складності проекту і рекомендацією щодо архітектури (хмарна vs on-premise, рівень custom processing).
Участь внутрішньої команди: потрібен доступ до документальної бази і 5–7 годин часу ключових користувачів.
Детальніше про автоматизацію документообігу — на сторінці послуги.
Фаза 2 — тижні 3–6: metadata-схема і пілот на чистому корпусі
Задачі: – Розробка domain-specific metadata-схеми з доменними експертами клієнта (юристи, регуляторні спеціалісти, фінансисти — залежно від галузі) – Вибір чистого підкорпусу для пілоту (500–1000 найякісніших документів з однієї предметної області) – Налаштування document processing pipeline з ієрархічним chunking – Запуск пілотної системи для 5–10 beta-users – Збір feedback і першої ітерації на реальних запитах
Ключове рішення цієї фази: on-premise або хмара. Якщо є compliance-обмеження — on-premise, GPU-конфігурація визначається тут. Це займає час на procurement, тому вирішувати треба не відкладаючи.
Результат фази: пілотна система, яка відповідає на запити у вузькій предметній області з прийнятною якістю.
Фаза 3 — місяці 2–3: production infra, concurrent load, моніторинг
Задачі: – Розгортання production infrastructure з queue management і semaphores – Load testing: симуляція реального concurrent навантаження (50–100 паралельних користувачів) – Налаштування monitoring і alerting: GPU utilization, response time, error rate – Audit trail logging для compliance-вимог – Розширення корпусу на «decent» документи після їх preprocessing
Участь внутрішньої команди: потрібен IT-адміністратор для налаштування інфраструктури і безпекових обмежень (access control, мережеві правила).
Фаза 4 — місяць 4+: ітерація на реальних запитах, розширення корпусу
Після запуску production система починає збирати реальні дані: які запити не матчаться, які відповіді неточні, де metadata-схема має прогалини.
Постійні задачі: – Аналіз failed queries: що не знайшла система і чому – Поповнення keyword base для metadata extraction – Обробка «garbage» документів: пріоритизація за бізнес-цінністю, ручне виправлення або покращений OCR – Розширення на нові підкорпуси або відділи
Добра новина: близько 60–70% коду і підходів реюзабельні між різними відділами або навіть клієнтами. Після першого повного впровадження кожне наступне розширення значно дешевше і швидше.
Скільки це коштує і коли окупиться
ROI-формула для CTO — приклад: юридична компанія
Конкретний приклад для розрахунку:
Юридична фірма з 50 юристами. Кожен витрачає в середньому 2 години на день на пошук по документах — справах, судовій практиці, нормативних актах. При середній вартості години роботи юриста:
50 юристів × 2 год/день = 100 год/день втрат на «документальний пошук»
Правильно побудована RAG-система скорочує цей час мінімум на 70–80%. Навіть консервативно — 70% економія на 100 годинах на день — дає 70 годин, повернених у продуктивну роботу щодня.
Для порівняння: система за фіксовану вартість, що окупається за кілька десятків робочих днів при такій щоденній економії — це аргумент не для IT-бюджету, а для фінансового директора.
Аналогічна логіка застосовується для фармацевтичних компаній (аналітики регуляторних відповідностей), банків (due diligence і compliance-аналітики), HR-аутсорсингу (обробка кадрових документів).
Що збільшує вартість: compliance, старі документи, on-premise GPU
Три фактори, які збільшують вартість і час реалізації порівняно з базовими оцінками:
Compliance-вимоги. Якщо потрібні audit trails, розмежування доступу до рівня документа, звітність для регуляторів — це додатковий інженерний шар. Плюс юридичний аналіз: що можна, що не можна, які дані залишаються строго on-premise.
Якість документального архіву. Якщо 30–40% корпусу потрапляє у категорію «garbage» (погана якість OCR, рукописи, нечитабельні скани) — потрібен додатковий preprocessing. Для деяких критичних документів — ручна обробка або покращений OCR зі спеціалізованими моделями.
On-premise GPU. RTX 4090 не вирішує задачу concurrent users. Якщо потрібна on-premise інфраструктура для compliance — бюджетуйте на A100. І плануйте час на procurement і налаштування: це не хмара, де ресурси з’являються за лічені хвилини.
Як Directoria підходить до enterprise RAG-проектів
Ми не починаємо з вибору моделі. Ми починаємо з document quality audit.
Практика 10+ enterprise-впроваджень призвела до чіткого процесу:
Крок 1. Document quality audit (5 днів). Аналіз структури і якості документального корпусу клієнта. Класифікація за трьома класами. Виявлення «прихованих» таблиць і перехресних посилань. Результат — технічний звіт: що є, яка складність, яка рекомендована архітектура.
Крок 2. Metadata-схема. Разом з доменними експертами клієнта проектуємо domain-specific схему — не загальну, а таку, що відповідає реальним запитам реальних користувачів у конкретній галузі.
Крок 3. Пілот на чистому підкорпусі. Обмежений масштаб, реальні користувачі, реальні запити. Мета — не «чи працює система», а «де metadata-схема неповна і які failure modes у реальному використанні».
Крок 4. Production. Queue management, semaphores, monitoring, audit trails — повний production-стек, а не demo-середовище.
Перший крок — безкоштовний AI-аудит за 5 днів — дає конкретну карту документального стану і рекомендацію щодо архітектури. Замовте аудит і дізнайтеся, з чого реально складається ваш проект, ще до прийняття бюджетних рішень.
Часті питання CTO
У нас 20 000 документів у SharePoint — з чого починати?
Починайте з document quality audit: візьміть 200–300 документів вибірково з різних розділів SharePoint і класифікуйте їх за якістю (clean / decent / garbage). Це займає 2–3 дні і дає критичну інформацію: який відсоток документів потребує спеціального preprocessing, де знаходяться таблиці з критичними даними, яка реальна складність проекту. Без цього audit будь-яка оцінка вартості і термінів буде хибною.
Чи можна використовувати GPT-4o для enterprise RAG, якщо немає compliance-обмежень?
Так, GPT-4o — технічно якісний варіант для retrieval і відповідей. Основне обмеження — вартість при high-volume обробці (50K+ документів, тисячі запитів/день): різниця у вартості порівняно з on-premise open-source моделями стає суттєвою. Другий момент — rate limits API: при пікових навантаженнях 50+ concurrent users можуть виникати затримки. Якщо обсяг невеликий і бюджет дозволяє — GPT-4o є прийнятним вибором для старту. Для масштабованого production — варто рахувати.
Скільки ML-інженерів потрібно для підтримки RAG в production?
Для підтримки стабільної системи після впровадження — 0.5–1 FTE з досвідом Python і базовим розумінням LLM-інфраструктури. Якщо система добре побудована з monitoring і alerting, більшість проблем видно заздалегідь і вирішуються конфігурацією, а не переробкою коду. Складніші задачі — розширення на нові підкорпуси, налаштування нових metadata-схем, major апгрейди моделі — виконуються підрядником за потреби.
Що якщо наша база документів постійно поповнюється?
Це нормальний production-сценарій. Система будується з підтримкою incremental indexing: нові документи проходять той самий pipeline (quality check → metadata extraction → chunking → embedding) і додаються до існуючого індексу без повної переіндексації. Частота оновлення залежить від потреб: для деяких клієнтів — real-time (нові документи доступні в системі через 15–30 хвилин), для інших — batch раз на добу достатньо. Background tasks для нових документів запускаються з нижчим GPU-пріоритетом, щоб не впливати на production-запити.
Чи реюзабельна архітектура між різними відділами компанії?
Так, близько 60–70% коду і infrastructure реюзабельні між відділами або навіть між клієнтами в одній галузі. Що потрібно адаптувати для кожного відділу: metadata-схема (різні типи документів і поля), keyword base для extraction, правила access control (який відділ бачить які документи). Сам processing pipeline, embedding-модель, infrastructure stack і monitoring — переносяться без переробки. Тому після першого відділу кожне наступне розширення йде значно швидше і дешевше.
Чому PoC завжди успішний, а production ламається?
PoC будується на «вишнятих» документах: обраних вручну, хорошої якості, однотипних. Production отримує весь корпус — включаючи garbage docs, неструктуровані таблиці, документи з переплутаним OCR і перехресними посиланнями. PoC тестується одним користувачем без concurrent load. Production — 50 одночасних запитів у пікові години. І PoC ніколи не тестується з реальними запитами реальних користувачів, які мають специфічну галузеву термінологію і acronyms. Це не проблема з RAG — це різниця між controlled demo і production engineering.
Висновок
Enterprise RAG — це будівельний проект, а не ML-задача.
Основна теза, яку підтверджує практичний досвід 10+ впроваджень:
«Enterprise RAG is way more engineering than ML. Most failures aren’t from bad models — they’re from underestimating the document processing challenges, metadata complexity, and production infrastructure needs.» «Enterprise RAG — це значно більше engineering, ніж ML. Більшість провалів — не від поганих моделей, а від недооцінки складності обробки документів, метаданих і production-інфраструктури.»
Хто будує правильний фундамент — document quality detection, domain-specific metadata, hybrid retrieval, production infrastructure з queue management — отримує систему, яка надійно працює і скорочує пошук по документах з годин до хвилин.
Хто починає з вибору моделі і PoC на чистих 500 документах — отримує демо, яке чудово виглядає на презентації і падає в production.
Перший крок — не вибір між GPT-4o і Qwen. Перший крок — аудит документального хаосу, який у вас є прямо зараз. Замовте безкоштовний AI-аудит і отримайте чесну картину: що є, скільки коштуватиме впорядкувати, і яка архітектура підійде для вашого корпусу.