Уявіть: ваш менеджер підтримки щодня відповідає на 80 однотипних запитань про умови доставки, повернення товару і гарантійне обслуговування. Ви встановлюєте чат-бот на базі ChatGPT — і він починає «помагати». Через тиждень клієнт пише в соцмережах: бот пообіцяв безкоштовне повернення протягом 60 днів, хоча у вас діє 14-денний термін. AI відповів впевнено — і помилився.
Це не баг конкретного чат-бота. Це фундаментальна особливість великих мовних моделей (LLM, Large Language Models): вони не знають вашого бізнесу. Вони навчені на мільярдах сторінок загального тексту з інтернету — і відповідають на основі цього загального знання, а не ваших договорів, прайсів і внутрішніх регламентів.
RAG (Retrieval-Augmented Generation, доповнена генерація з пошуком) — це архітектурне рішення, яке змінює цю ситуацію. Замість того щоб AI вигадував відповіді з голови, він спочатку шукає відповідну інформацію у вашій базі документів — і тільки потім формулює відповідь.
У цій статті ми пояснимо, як це працює без технічного жаргону, покажемо конкретні бізнес-сценарії і дамо орієнтири по вартості — щоб ви зрозуміли за 10 хвилин читання, чи підходить RAG вашій компанії.
Чому звичайний ChatGPT не знає вашого бізнесу
Як LLM «думає» — і де його пам’ять обривається
Велика мовна модель — це, грубо кажучи, дуже складний статистичний механізм. Під час навчання вона «читала» колосальні масиви тексту і навчилась передбачати, яке слово ймовірно стоїть наступним у тому чи іншому контексті. Завдяки цьому вона може зв’язно відповідати на запитання, писати листи, перекладати — і навіть вести переговори.
Але у неї є жорстке обмеження: вона знає тільки те, на чому навчалась. А навчання відбувалось один раз — до певної дати (так звана дата зрізу знань). Все, що сталось після — ChatGPT не знає. Ваші нові прайси, оновлені умови договору, інструкції для нових співробітників — для моделі цього не існує.
Крім того, модель не має доступу до ваших корпоративних систем: CRM, внутрішнього wiki, папок з документами. Коли ви питаєте її «яка наша знижка для постійних клієнтів», вона не знає відповіді — і може або чесно сказати «не знаю», або, що гірше, вигадати правдоподібну відповідь.
Типова ситуація: бот відповідає впевнено, але неправильно
Подивімось на реальну ситуацію. Компанія-дистриб’ютор обладнання налаштовує GPT-бота для відповідей клієнтам. Модель навчена на загальних текстах і інструкціях — але не знає специфіки конкретних моделей обладнання цієї компанії. Клієнт питає: «Чи сумісний насос А із системою охолодження Б?» Бот відповідає впевнено — і помиляється. Технік виїжджає на монтаж і знаходить несумісність. Компанія несе витрати на повторний виїзд і втрачає довіру клієнта.
Ця ситуація — не виняток. За оцінками практиків галузі, стандартні GPT-боти без прив’язки до корпоративної бази помиляються у відповідях на специфічні запитання в 30–60% випадків — залежно від вузькості теми.
Що таке «галюцинація» і чому це проблема для бізнесу
«Галюцинація» (hallucination) — термін, яким дослідники AI описують ситуацію, коли модель генерує впевнену, граматично правильну, але фактично неправдиву відповідь. Вона не брехня навмисна — модель просто не розрізняє, де вона знає факт, а де заповнює прогалину правдоподібним текстом.
Для особистого використання це неприємно, але не критично. Для бізнесу — це юридичний і репутаційний ризик. Якщо бот пообіцяв клієнту умови, яких немає в договорі — це потенційний судовий спір. Якщо бот дав неправильну технічну інструкцію — це аварія на об’єкті. Якщо новий співробітник отримав від внутрішнього бота неправильну інформацію про процедуру — це операційна помилка.
RAG вирішує саме цю проблему: він «прив’язує» відповіді AI до конкретних джерел із вашої бази.
Що таке RAG — пояснення без технічного жаргону
Метафора: Google + ChatGPT, але для вашої корпоративної бази
Уявіть, що Google і ChatGPT працюють разом — але замість всього інтернету вони обшукують тільки ваші внутрішні документи.
Коли клієнт або співробітник задає питання, система спочатку шукає найрелевантніші фрагменти у вашій базі документів (як Google шукає сторінки). Потім передає ці фрагменти в мовну модель — і вже модель формулює відповідь на основі знайденого (як ChatGPT пише текст).
Ключова відмінність від звичайного GPT: модель не вигадує відповідь з загальних знань — вона спирається на конкретні фрагменти ваших документів. Якщо відповіді в базі немає — система може чесно сказати «такої інформації у нас немає» замість того, щоб вигадувати.
Три кроки RAG: запит → пошук → відповідь
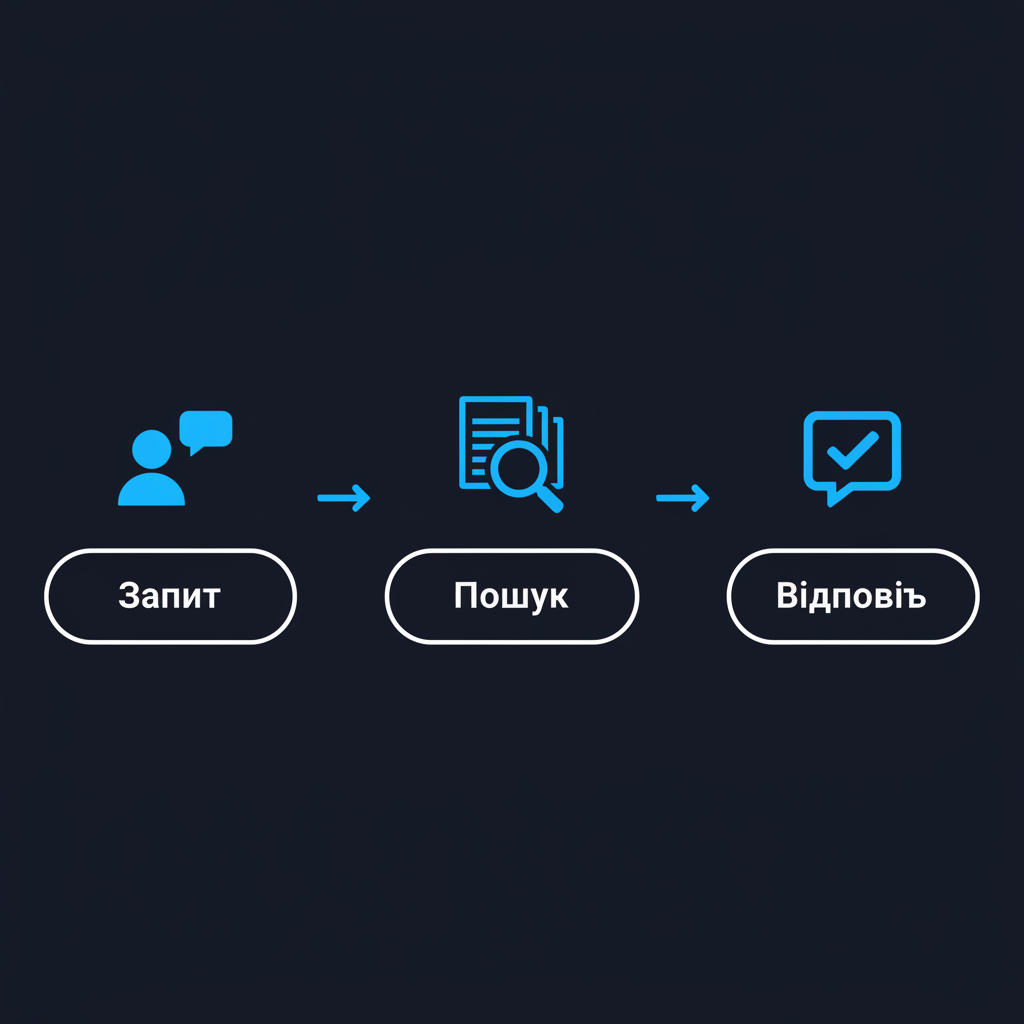
Процес виглядає так:
Крок 1 — Запит. Користувач або клієнт ставить питання в звичному форматі живої мови: «Яка вартість доставки до Львова для замовлення понад 5000 грн?»
Крок 2 — Пошук. Система перетворює питання на математичний вектор і знаходить у базі документів найближчі за змістом фрагменти: наприклад, відповідні абзаци з умов доставки та прайс-листа.
Крок 3 — Відповідь. Мовна модель отримує питання + знайдені фрагменти і формулює зв’язну відповідь: «Доставка до Львова при замовленні від 5000 грн — безкоштовна. Термін — 2–3 робочих дні “Новою поштою”».
Весь процес займає 1–3 секунди — і у відповіді є пряме посилання на джерело (документ і сторінку), звідки взята інформація.
Що є «базою знань» — документи, сайт, CRM, листування
Базою знань для RAG може бути практично будь-який текстовий контент вашої компанії:
- PDF-документи: договори, технічні специфікації, інструкції, прайс-листи
- Word- і Excel-файли: регламенти, скрипти продажів, шаблони листів
- Сайт компанії: сторінки послуг, FAQ, умови роботи
- База знань у Notion, Confluence або Google Docs
- Архів листування (якщо важливі прецеденти)
- Дані з CRM у форматі текстових нотаток або коментарів
Система не вимагає унікального формату. Достатньо завантажити документи — і RAG-система автоматично їх «індексує» (розбиває на фрагменти і перетворює на векторний пошук).
Як RAG відрізняється від fine-tuning і звичайного промпту
Таблиця порівняння: RAG / Fine-tuning / Звичайний GPT
| Критерій | Звичайний GPT | Fine-tuning | RAG |
|---|---|---|---|
| Знання вашого бізнесу | Немає | Обмежено (знімок на дату навчання) | Актуальна база |
| Оновлення даних | Неможливо без перенавчання | Перенавчання = витрати | Миттєво (додати документ) |
| Ризик галюцинацій | Високий | Середній | Низький (прив’язка до джерел) |
| Вартість запуску | Низька | Висока (навчання коштує $5 000–50 000+) | Середня |
| Вартість підтримки | Низька | Висока (перенавчання при змінах) | Низька |
| Прозорість відповідей | Немає (чорна скринька) | Немає | Є (посилання на джерело) |
| Підходить для | Загальних задач | Специфічного стилю/галузі | Корпоративних знань |
Fine-tuning (донавчання) — це процес, при якому модель перенавчається на ваших даних. Результат: вона починає «говорити» у вашому стилі і знати вашу специфіку. Але є принципова проблема: навчання — це статичний знімок. Якщо ваші документи змінились — треба перенавчати знову. І кожне перенавчання коштує значних ресурсів.
RAG натомість не змінює модель — він змінює те, що модель бачить перед відповіддю. Документи можна оновлювати в режимі реального часу без жодних додаткових витрат на переналаштування.
Коли RAG — найкращий вибір
RAG доцільний, якщо у вас є хоча б одна з цих ситуацій:
- Часто оновлювані дані. Прайси, умови, регуляції змінюються частіше ніж раз на квартал — fine-tuning не встигне.
- Конфіденційна інформація. Ви хочете контролювати, що саме AI знає — і не передавати дані у загальну навчальну вибірку.
- Підзвітність. Вам критично важливо знати, звідки взялась та чи інша відповідь (юридична, фінансова сфера).
- Обсяг понад 50–100 документів. Велику базу знань неможливо «вставити» в промпт — потрібен пошук.
Коли RAG надлишковий
Є ситуації, де RAG — зайве ускладнення:
- База знань невелика (5–10 документів) і рідко змінюється: достатньо системного промпту з ключовими даними.
- Завдання не потребує бізнес-специфіки: перекласти лист, написати email, узагальнити загальний текст — тут і ChatGPT без RAG впорається.
- Немає структурованої документації: якщо знання компанії «в головах» у людей і не зафіксовані — спочатку потрібен аудит документів, а вже потім RAG.
5 бізнес-сценаріїв, де RAG дає результат вже за 2–3 тижні
Підтримка клієнтів: бот на базі FAQ, інструкцій та умов доставки
Компанія з інтернет-торгівлі отримує 300–500 звернень на день. З них 60–70% — це однотипні запитання: умови доставки, терміни повернення, статус замовлення, наявність на складі. Менеджери витрачають на це 4–5 годин щодня.
RAG-бот, навчений на FAQ, умовах доставки і каталозі, може відповісти на такі запитання миттєво і точно — 24/7. За нашою практикою, при якісно підготовленій базі документів 60–80% типових запитань вирішуються без участі оператора. Менеджери переключаються на складні випадки, які потребують живого спілкування.
Посилання на послугу: AI-чатботи для сайту і месенджерів — там описано, як ми будуємо подібні рішення.
Онбординг нових співробітників: корпоративна вікі без пошуку в папках
Новий співробітник у перший тиждень задає сотні питань: як оформити відрядження, де шаблон договору, яка процедура узгодження рахунків, до кого звертатись з питань IT. Зазвичай він шукає у загальних папках, питає колег, губиться.
RAG-асистент, навчений на HR-документах, регламентах, організаційній структурі і внутрішніх процедурах, відповідає миттєво і точно. Замість «пошукай у папці HR/2023» — «Відрядження оформлюється через форму у розділі 4 Положення про відрядження. Ось посилання: [документ, сторінка 7]».
За нашими спостереженнями, онбординг зі RAG-асистентом скорочує час «входу» нового співробітника з 3–4 тижнів до 7–10 днів.
Внутрішній юридичний асистент: договори, регуляції, NDA-шаблони
Юридичний або комплаєнс-відділ щодня отримує запити від менеджерів: «Чи є у нас шаблон NDA для партнерів з ЄС?», «Які вимоги до конфіденційності у договорі з держорганом?», «Яка відповідальність у цьому пункті договору?»
Юрист витрачає 30–60 хвилин на пошук і відповідь. RAG-асистент з базою внутрішніх договорів, шаблонів і нормативних документів знаходить відповідне за секунди — і направляє до конкретного документа і пункту.
Важлива застереження: RAG не замінює юриста при складних угодах і нестандартних ситуаціях. Він забирає рутинний пошук і прості довідкові запити — і вивільняє юриста для реальної аналітичної роботи.
Відділ продажів: відповіді на заперечення на основі ваших скриптів
Менеджер на зустрічі з клієнтом чує заперечення: «Дорого», «Маємо вже рішення від конкурента», «Не впевнений, що це нам підходить». Відповідь на ці заперечення є в корпоративному скрипті продажів — але менеджер або не пам’ятає, або шукає в телефоні під час розмови.
RAG-асистент (у форматі внутрішнього мобільного застосунку або бота в Telegram/Slack) дозволяє менеджеру за 5 секунд отримати рекомендовану відповідь на конкретне заперечення — з урахуванням галузі клієнта і типу угоди. База знань: скрипти продажів, кейс-стаді, порівняльні таблиці з конкурентами, відповіді на типові заперечення.
Технічна підтримка продукту: база помилок і рішень для L1/L2
IT-компанія або виробник технічного обладнання має лінію підтримки першого рівня (L1). Спеціалісти L1 часто не знають всіх технічних деталей і переводять запит на L2 — де досвідчений інженер дивиться в документацію і відповідає. Час очікування: від кількох годин до доби.
RAG-система з базою технічної документації, відомих помилок і рішень дозволяє L1-спеціалісту знаходити рішення відразу: «Помилка ERR_5042 на моделі Х — перевірте підключення кабелю живлення і перезапустіть конфігуратор (інструкція, кроки 3–5)». За оцінками ринку, такий підхід знижує кількість ескалацій на L2 на 40–60%.
Що потрібно, щоб запустити RAG — і скільки це коштує
Мінімальний стек: які документи, який обсяг — з чого починати
Хороша новина: для запуску пілоту не потрібна ідеальна документація. Потрібна достатня.
Мінімальний поріг для RAG-системи — приблизно 20–50 структурованих документів загальним обсягом від 50–100 сторінок. Це може бути: – FAQ у форматі Word або Google Docs – Умови роботи та договори – Технічні специфікації або каталог продуктів – Внутрішні регламенти і процедури
Якість документів важливіша за кількість. Суперечливі, застарілі або хаотично написані документи знизять якість відповідей — і система буде плутатись. Тому перший крок — аудит документальної бази.
Що перевіряємо на аудиті: – Чи є у документах актуальна і структурована інформація? – Чи немає суперечностей між різними документами? – Яка частота оновлень — і хто відповідає за оновлення? – Які питання найчастіше задають клієнти або співробітники?
Документообіг і підготовку бази ми описуємо на сторінці послуги з автоматизації документів.
Хмарні варіанти vs self-hosted — ризики і переваги для UA-бізнесу
При розгортанні RAG-системи є два основних підходи:
Хмарні рішення (Azure OpenAI, AWS Bedrock, Google Vertex AI) — документи обробляються і зберігаються на серверах провайдера. Переваги: швидкий старт, масштабованість, без потреби в DevOps. Ризики: дані виходять за периметр компанії, вимоги до compliance у деяких галузях (медицина, держсектор, фінанси) можуть це забороняти.
Self-hosted — система розгортається на власному сервері або у приватному хмарному середовищі. Переваги: повний контроль над даними, відповідність вимогам захисту персональних даних. Ризики: потрібні DevOps-ресурси, вищі операційні витрати, складніше масштабувати.
Для більшості українських B2B-компаній у 2026 році хмарний підхід з правильно налаштованими правами доступу є достатньо безпечним — при умові, що документи не містять персональних медичних або фінансових даних. Чутливі кейси (банки, медичні заклади, держструктури) потребують self-hosted або гібридного підходу.
Орієнтовна вартість пілоту і повного впровадження
Ці цифри — орієнтири, а не прайс. Реальна вартість залежить від обсягу документів, кількості кінцевих користувачів і вибраної архітектури.
Пілот (1 сценарій, 1–2 канали, 2–4 тижні): – Аудит документів і підготовка бази: 15 000–25 000 ₴ – Розгортання RAG-системи: 20 000–40 000 ₴ – Налаштування і тестування: 10 000–20 000 ₴ – Разом пілот: 45 000–85 000 ₴
Повне впровадження (2–3 сценарії, інтеграція з CRM/сайтом, навчання команди): – 80 000–250 000 ₴ залежно від обсягу і складності
Щомісячні операційні витрати (після запуску): – Хмарні API (OpenAI/Azure/інші): 3 000–15 000 ₴/місяць залежно від навантаження – Підтримка і оновлення бази: 5 000–15 000 ₴/місяць (якщо не власна команда)
Орієнтовний ROI: при відділі підтримки з 3–5 операторів, де RAG закриває 60% запитань автоматично, економія на FTE становить 60 000–120 000 ₴/місяць. Пілот окупається за 1–2 місяці після запуску.
Типові терміни: від аудиту документів до першого живого бота
- Тиждень 1: аудит документів, вибір сценарію для пілоту
- Тиждень 2: підготовка бази знань, налаштування системи
- Тиждень 3: перший прототип, внутрішнє тестування
- Тиждень 4: коригування, підключення до каналу (сайт, Telegram, Slack)
- Місяць 2: збір метрик, ітерація, розширення бази
Через 4–6 тижнів після початку аудиту — перший живий бот, який відповідає клієнтам або співробітникам. Не через 6 місяців і не після написання власного коду.
4 помилки при впровадженні RAG, які зводять нанівець результат
Брудна база знань: застарілі документи, суперечливі інструкції
Це найпоширеніша помилка — і вона виникає ще до написання першого рядка коду.
Уявімо: у вас є папка «Документи» на Google Drive з 200 файлами. Там умови доставки 2021 року і умови 2024 року — обидва активні, але суперечать одне одному. Є прайс з квітня і прайс з жовтня. Є внутрішній регламент, написаний рукою HR-менеджера, яка пішла два роки тому.
Якщо завантажити цей «зоопарк» у RAG — система буде видавати неправильні або суперечливі відповіді. Не тому що RAG поганий, а тому що сміття на вході = сміття на виході.
Рішення: перед впровадженням провести аудит документів — виявити дублікати, застарілі версії, суперечності. Призначити відповідального за оновлення бази.
Очікування «магії» без підготовчого аудиту
Деякі компанії уявляють RAG як: «завантажуємо всі файли — і все одразу запрацює». Ні.
RAG — це інструмент, а не магія. Як молоток у руках некваліфікованого будівельника: технічно правильний інструмент, але без підготовки результат буде поганий.
Перш ніж впроваджувати — потрібно відповісти на питання: – Який конкретний сценарій ми автоматизуємо? – Які питання задають найчастіше? – Де є відповіді на ці питання — і чи вони актуальні? – Хто буде відповідати за якість бази знань після запуску?
Без цих відповідей — впровадження перетвориться на дорогий експеримент без результату.
Немає процесу оновлення бази після запуску
RAG — це не «налаштував і забув». Бізнес змінюється: з’являються нові продукти, змінюються умови, оновлюються регуляції. Якщо база знань не оновлюється — бот починає відповідати застарілою інформацією.
Необхідно від початку визначити: – Хто відповідає за оновлення бази (конкретна людина, не «всі»)? – Яка процедура додавання нового документа? – Як перевіряється якість відповідей після оновлення? – З якою частотою проводиться «прибирання» застарілих документів?
Без чіткого процесу оновлення система деградує протягом 3–6 місяців після запуску.
Не вимірюється якість відповідей: немає метрик, немає покращень
«Бот відповідає» — це не метрика. Метрика — це «бот правильно відповідає на X% запитань і клієнти не переходять до оператора».
Без вимірювання ви не знаєте: – Скільки відсотків запитань бот вирішує самостійно? – На які теми бот помиляється найчастіше? – Чи зросла задоволеність клієнтів або знизилось навантаження на операторів?
Рекомендований мінімальний набір метрик: – Відсоток запитань, вирішених без ескалації до людини (ціль: 60%+) – Відсоток позитивних оцінок від користувачів (якщо є кнопка «корисно/некорисно») – Середній час відповіді – Кількість унікальних запитань, на які система не знайшла відповіді
Ці дані — дорожня карта для покращення. Без них ви вдосконалюєте систему навмання.
Детальніше про підхід до вимірювання результатів — на сторінці AI-асистента підтримки.
Як це виглядає на практиці: наш підхід до RAG-проектів
Ми в Directoria не продаємо технологію заради технології. Ми шукаємо конкретний бізнес-процес, де RAG дасть вимірний результат — і будуємо рішення під нього.
Наш процес виглядає так:
Крок 1. AI-аудит (5 робочих днів). Ми аналізуємо вашу документальну базу, процеси і точки болю. На виході — карта документів, оцінка готовності до RAG і рекомендація: чи підходить цей підхід, і якщо так — який сценарій починати першим.
Крок 2. Вибір архітектури. Хмара чи self-hosted? Який LLM? Яка векторна база? Цей вибір залежить від вашого обсягу даних, чутливості інформації і бюджету. Ми пропонуємо варіанти з чіткими tradeoffs — і ви обираєте.
Крок 3. Пілот за 2–3 тижні. Один сценарій, один канал, реальні користувачі. Ціль — перевірити, чи дає система результат на вашій базі, до того як інвестувати у повне впровадження.
Крок 4. Вимірювання і ітерація. Після 2–4 тижнів роботи у реальних умовах — аналіз метрик, виявлення слабких місць бази, оновлення. Тільки після підтвердження результату — масштабування на інші сценарії.
Фіксована ціна пілоту обговорюється на старті — без «а потім виявилось» і прихованих витрат.
Якщо вам цікаво зрозуміти, чи підходить RAG вашому бізнесу — почніть з AI-аудиту. За 5 днів ми дамо конкретну відповідь, не загальні слова.
Дізнатися, чи підходить RAG для вашого бізнесу
Часті питання
Чи безпечно завантажувати корпоративні документи в AI?
Це залежить від архітектурного рішення. При використанні корпоративних хмарних сервісів (Azure OpenAI, AWS Bedrock) ваші документи не потрапляють у загальні навчальні дані — вони залишаються у вашому хмарному просторі. Ви підписуєте угоду про обробку даних з провайдером, де це прямо зафіксовано.
Для особливо чутливих даних (персональні дані фізосіб, медичні записи, фінансова звітність) — рекомендуємо self-hosted підхід, де дані взагалі не виходять за периметр вашої IT-інфраструктури. Для більшості B2B-компаній хмарний підхід із правильними налаштуваннями є безпечним і достатнім.
Що якщо наші дані постійно змінюються?
Це якраз перевага RAG, а не проблема. Оновити базу знань — значить просто завантажити новий або змінений документ. Система перерахує вектори для оновленого контенту протягом хвилин — без перенавчання, без зупинки сервісу.
Головне — призначити відповідального за оновлення і виробити простий процес: «нова версія документа → завантажити в систему → позначити старий як архівний». Це займає 5–10 хвилин, а не дні розробки.
RAG точно не вигадуватиме відповіді?
RAG суттєво знижує ризик галюцинацій, але не усуває їх повністю. Коли система знаходить конкретний фрагмент у документах — вона спирається на нього, а не вигадує. Але якщо питання не охоплено базою — є ймовірність, що модель спробує «домислити».
Тому правильно налаштована RAG-система має явний поріг: «якщо релевантний документ не знайдено — відповідати “Такої інформації у нашій базі немає, зверніться до менеджера”». Це налаштовується на рівні промпту і є стандартною практикою при якісному впровадженні.
Чи потрібен нам власний IT-відділ для впровадження?
Ні. RAG-система може бути розгорнута і підтримуватись зовнішнім підрядником — як будь-яке інше ПЗ або хмарний сервіс. Вашій команді потрібно розуміти тільки одне: як завантажувати нові документи і перевіряти якість відповідей.
Технічну підтримку, оновлення системи і моніторинг ми беремо на себе — це частина договору на підтримку після впровадження. Ваш менеджер або HR-спеціаліст може оновлювати базу знань через звичайний веб-інтерфейс — без коду і без IT.
Скільки документів потрібно, щоб система запрацювала?
Технічний мінімум — 10–15 документів. Але для реально корисної системи рекомендуємо 50+ сторінок структурованого контенту, який охоплює основні питання у вашому сценарії.
Якщо документів мало — часто достатньо спочатку написати базовий FAQ (20–30 питань/відповідей) і на його основі запустити пілот. Ми допомагаємо структурувати і підготувати базу — це частина аудиту.
Чи працює RAG українською мовою?
Так. Сучасні LLM (GPT-4o, Claude 3, Gemini 1.5 та інші) добре розуміють і генерують українськомовний текст. Якість роботи з українською мовою у 2025–2026 роках є прийнятною для комерційних задач.
Є нюанс: векторний пошук у базі знань краще працює, якщо мова документів і мова запитів збігаються. Тобто якщо документи українською — запити теж варто формулювати українською. У мішаних середовищах (документи мовами, запити іншою) — налаштування потребує додаткових кроків, але це вирішувана задача.
Висновок
RAG-архітектура — це не технологія заради технології. Це рішення конкретної бізнес-проблеми: AI відповідає не з голови, а з ваших документів. Результат — точні відповіді, менше галюцинацій, вимірна економія на рутинних операціях.
Якщо ваша компанія має 50+ сторінок актуальних документів і хоча б один процес, де люди витрачають час на однотипні відповіді — RAG, за нашою практикою, дає вимірний результат вже через 4–6 тижнів після початку роботи.
Перший крок — не вибір технологій і не написання коду. Перший крок — аудит: розуміємо, які документи є, які питання найчастіші, де RAG дасть максимальну віддачу. Саме з цього ми починаємо.
Замовити AI-аудит за 5 днів — і отримайте карту документів і конкретну рекомендацію по вашому кейсу.