Уявіть ситуацію: ви витратили місяці на впровадження AI-чатбота, який мав би відповідати на запитання ваших менеджерів по внутрішній документації. На демонстрації він виглядав чудово — відповідав на стандартні питання, знаходив загальну інформацію, справляв враження. Але щойно реальна команда почала використовувати систему для роботи, виникла проблема: коли менеджер запитує про конкретний пункт договору, специфіку регуляторної вимоги або точні показники з квартального звіту — бот або мовчить, або відповідає щось схоже, але не те.
Саме в цей момент більшість команд починає думати, що їм потрібна «краща AI-модель». Але проблема майже ніколи не в моделі.
Ця стаття базується на реальному досвіді практика, який описав свої 10+ enterprise-впроваджень RAG-систем у спільноті r/AI_Agents. Його пост зібрав майже тисячу відгуків від інших фахівців — для технічної теми це надзвичайно висока оцінка. За його плечима — проекти у фармацевтиці, банківській сфері і юридичних фірмах. Інформація у цій статті — не теорія з підручників, а зафіксовані закономірності реальних провалів і реальних рішень.
Детальніше про те, що таке RAG-архітектура і як вона влаштована — у нашому матеріалі «RAG-архітектура для бізнесу».
Звідки ці дані — і чому їм варто довіряти
Практик з 10+ enterprise-клієнтами
Автор оригінального матеріалу (нікнейм у спільноті r/AI_Agents) описав свій досвід побудови RAG-систем для компаній у трьох регульованих галузях: фармацевтика, банківська справа і юридичні послуги. Масштаб проектів — від 10 000 до 50 000+ документів у корпоративних сховищах. Це не стартапи з чистим аркушем, а компанії, які роками накопичували документацію в різних форматах, різної якості і з різними стандартами структурування.
Саме в таких умовах проявляються справжні слабкі місця RAG-систем. Демонстраційні стенди з кількома сотнями чистих PDF-файлів приховують ці проблеми — вони стають видимими тільки в продакшні.
Чому досвід практиків точніший за туторіали
Туторіали вчать, як побудувати RAG, що «працює». Реальний досвід показує, чому він перестає працювати в момент, коли на нього покладаються. Різниця принципова.
Туторіал показує ідеальний сценарій: чисті документи, просте питання, коректна відповідь. Enterprise-реальність — це скановані папери двадцятирічної давнини поруч із сучасними звітами на кілька сотень сторінок, таблиці з критичними показниками, перехресні посилання між документами і тисячі запитів від живих користувачів одночасно. Саме про це — ця стаття.
Головний міф: «RAG не працює через погану модель»
Насправді 80% результату — engineering, 20% — ML
Перше і найважливіше, що варто зрозуміти перед тим, як замовляти або будувати RAG-систему:
«Enterprise RAG is way more engineering than ML.» — «Enterprise RAG — це значно більше engineering, ніж ML».
Більшість команд, які замовляють AI-чатбот на базі документів, зосереджуються на виборі моделі: GPT-4, Claude, Gemini або щось open-source. Це хибна точка фокусу. Модель — це останній елемент пайплайну, і вона залежна від якості всього, що їй передається.
Якщо в систему потрапляє неякісний текст із зіпсованих PDF, якщо документи порізані без урахування їхньої структури, якщо метадані відсутні або неправильні — жодна модель, навіть найдорожча, не дасть правильної відповіді. Вона просто коректно сформулює неправильну інформацію.
Де насправді ламається більшість систем
«Most failures aren’t from bad models — they’re from underestimating the document processing challenges, metadata complexity, and production infrastructure needs.» — «Більшість провалів — не від поганих моделей, а від недооцінки складності обробки документів, метадати і production-інфраструктури.»
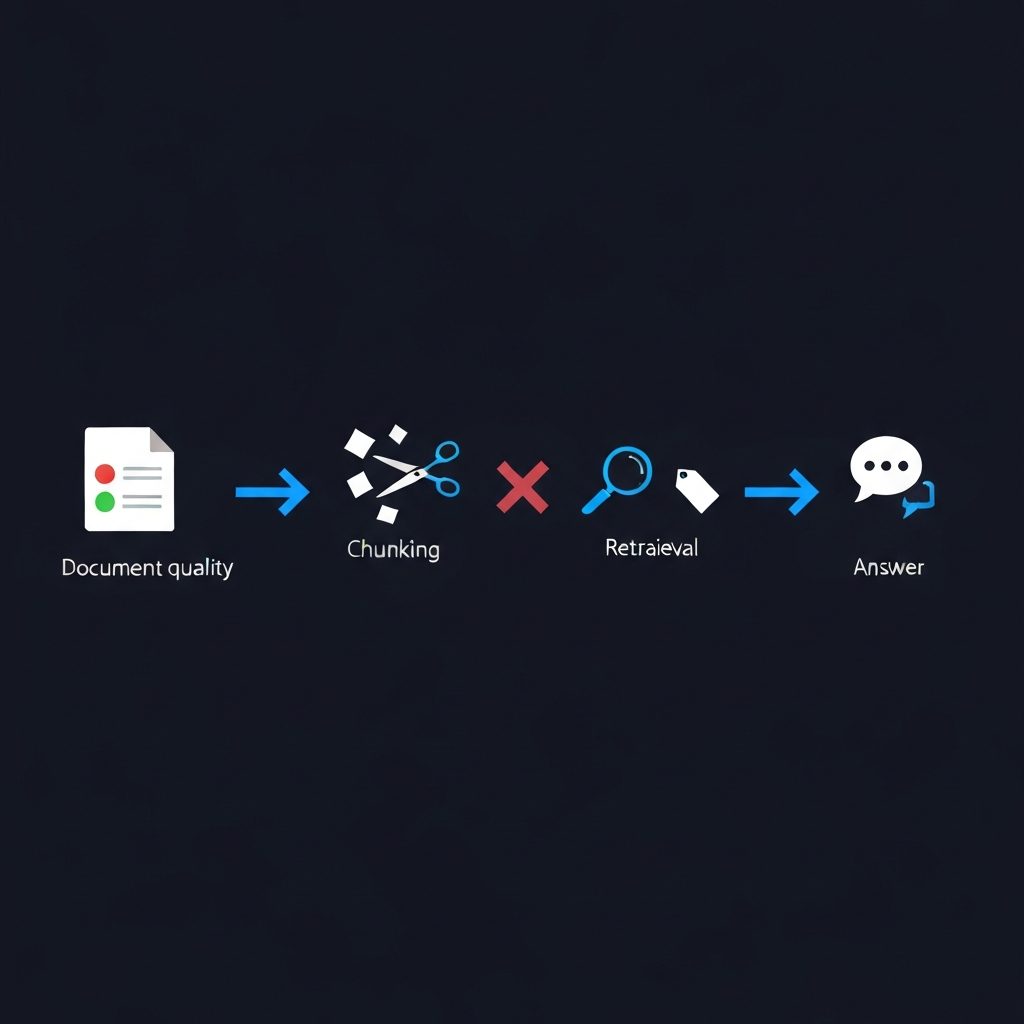
Є п’ять конкретних точок, де система ламається чи не ламається. Саме їм присвячена ця стаття: якість документів, підхід до чанкінгу (chunking — спосіб поділу тексту на фрагменти), метадані, обмеження семантичного пошуку і обробка таблиць.
Чому успішний демо-стенд і провальний продакшн — різні речі
Демонстрація RAG-системи відбувається на підготовлених документах: чистих, структурованих, написаних зрозумілою мовою. В продакшн приходять реальні корпоративні документи: зі змішаним форматуванням, з таблицями, зі скороченнями, специфічними для галузі, з посиланнями на інші документи, яких у базі може навіть не бути.
Різниця між демо і продакшном — це різниця між «система ніби працює» і «система реально вирішує бізнес-задачу». Провал між цими двома точками відбувається завжди з одних і тих самих причин.
Провал №1 — Якість документів, яку ніхто не перевіряє
Реальна корпоративна база: що там насправді лежить
Уявімо медичний центр або фармацевтичну компанію в Україні. За роки роботи накопичилися тисячі документів: клінічні протоколи, регуляторні висновки, дозволи на препарати, внутрішні інструкції, листування з регуляторами. Частина цих документів — скановані паперові документи 1990-х і 2000-х, частина — сучасні PDF на кілька сотень сторінок із таблицями і схемами, частина — файли, що колись були у Word, а потім кілька разів перезберігалися.
Усі ці документи надходять у RAG-систему без розбору. І перша проблема — система намагається обробляти їх однаково.
Один підхід chunking для всіх → система повертає нісенітницю
Chunking — це спосіб поділу документа на фрагменти перед тим, як зберігати їх у векторній базі. Коли система дістає відповідь, вона шукає найрелевантніші фрагменти і передає їх моделі.
Якщо документ відсканований нечітко, OCR (розпізнавання тексту) зробив помилки, або текст взагалі нечитабельний — система все одно буде порізана на фрагменти і збережена у векторній базі. Але ці фрагменти будуть наповнені спотвореним або беззмістовним текстом. При запиті система знаходить ці фрагменти як «релевантні» і передає їх моделі — яка, у свою чергу, або галюцинує відповідь, або повертає щось нейтральне типу «інформація не знайдена».
Document quality scoring: три категорії
Практичне рішення — ввести оцінку якості документів до того, як вони потрапляють у пайплайн. Три категорії:
Чисті документи — машинодрукований текст, правильна кодування, чітка структура. Такі документи проходять повну ієрархічну обробку.
Документи з артефактами — OCR-помилки, нестандартне форматування, часткова нечіткість. Базовий чанкінг з попереднім очищенням тексту.
Непридатні документи — сканований рукопис, нечитабельні сторінки, зіпсоване кодування. Фіксовані фрагменти з позначкою для ручної перевірки.
Ефект від цього одного кроку виявився більшим, ніж від будь-якого апгрейду embedding-моделі (моделі, яка перетворює текст на векторне представлення для пошуку). Причина проста: система перестає намагатися знайти відповідь там, де її немає.
Метафора для власника бізнесу
Уявіть бібліотеку, де половина книг надрукована нечитабельним шрифтом або частково залита кавою — а бібліотекар все одно намагається видавати їх читачам. Запит є, видача є, але інформація у виданому — сміття. Саме це відбувається з RAG-системою без оцінки якості документів.
Сторінка послуги «Автоматизація документообігу» містить більше інформації про те, як ми підходимо до аудиту документальних баз перед налаштуванням будь-якої AI-системи.
Провал №2 — Fixed-size chunking: туторіал versus реальність
Що вчать туторіали
Більшість навчальних матеріалів з RAG-систем пропонують простий рецепт: «порізайте ваші документи на фрагменти по 512 токенів з перекриттям у 50–100 токенів». Токен — це приблизно слово або частина слова, тобто мова йде про фрагменти довжиною приблизно пів сторінки.
Цей підхід зрозумілий, простий у реалізації і добре виглядає на тестових даних. Але він ігнорує одну очевидну річ: документи мають структуру.
Чому структуру документів не можна ігнорувати
Візьмемо клінічний звіт фармацевтичної компанії. Він має заголовок, резюме, методологічний розділ, результати, таблиці з дозуваннями, список посилань. Кожен розділ відповідає на різні типи питань. «Вступ» пояснює контекст, «Методи» описують умови дослідження, «Результати» містять конкретні показники.
Якщо нарізати цей документ по 512 токенів без урахування меж розділів, фрагменти будуть розривати логічні блоки. Запит «яка була методологія дослідження препарату X» може потрапити на фрагмент, що починається з кінця вступу і закінчується серединою методологічного розділу — і при цьому не містити відповіді на питання.
Ієрархічний chunking: рівні від документа до речення
Альтернатива — зберігати структуру документа і створювати фрагменти на різних рівнях:
- Рівень документа: заголовок, автори, дата, тип документа, стислий зміст
- Рівень розділу: Abstract, Methods, Results або інші структурні блоки
- Рівень параграфа: 200–400 токенів у межах одного логічного блоку
- Рівень речення: для дуже точних запитів
Кожен рівень зберігається окремо, але зі зв’язками між рівнями. При пошуку система розуміє, до якого розділу і документа належить знайдений фрагмент.
Складність запиту визначає рівень пошуку
Ключовий інсайт: різні запити вимагають різного рівня деталізації. Загальне питання «що таке препарат X» добре покривається фрагментом рівня розділу. Але запит «яка дозволена доза препарату X у таблиці 3 клінічного дослідження 2022 року» вимагає пошуку на рівні речення з прив’язкою до конкретної таблиці.
Якщо система не розрізняє ці рівні і завжди повертає фрагменти одного розміру — вона або дає занадто загальну відповідь на точний запит, або перевантажує контекст непотрібними деталями при загальному питанні.
Провал №3 — Метадані важливіші за вибір моделі
40% часу розробки — і найвищий ROI
З усіх аспектів побудови RAG-системи, метадані дають найбільшу віддачу. Практик, досвід якого описано в цій статті, зазначає:
«Spent 40% of my development time on metadata and it had the highest ROI of anything I built.»
Це означає: 40% часу розробки на одну компоненту — і при цьому найвища окупність з усього зробленого. Чому?
Тому що при пошуку по великій документальній базі семантика — тобто «схожість змісту» — не завжди є правильним критерієм. Якщо юрист шукає «договір з контрагентом Петренко від 2023 року», він хоче конкретний документ, а не «документи, схожі за змістом на договори з контрагентами».
Метадані дозволяють системі фільтрувати документи до того, як запускати семантичний пошук. Замість перебору тисяч фрагментів по всій базі, пошук йде по 50–100 документам, що відповідають фільтру «тип: договір, дата: 2023, контрагент: Петренко».
Чому не можна довіряти LLM витягання метаданих
Здавалося б, логічно: попросити саму модель витягти метадані з документів автоматично. Але цей підхід не працює надійно в enterprise-умовах.
Велика мовна модель витягає метадані непослідовно: той самий тип документа вона може назвати по-різному в різних запитах, скорочення в назвах препаратів або юридичних термінах вона розуміє неправильно, а рідкісні галузеві терміни вона просто не знає.
Що працює краще: простий keyword matching — пошук конкретних слів-маркерів у тексті. Якщо документ містить слово «договір» і дату у певному форматі — він отримує відповідні метадані. Це не «розумно», але це надійно.
Приклади схем метаданих для UA-бізнесу
Кожна галузь потребує власної схеми метаданих. Кілька практичних прикладів:
Юридична фірма: – Тип документа: договір / позов / висновок / судове рішення – Клієнт або справа – Дата підписання або подання – Юрисдикція – Контрагент або відповідач – Статус: чинний / архівний / оскаржується
Фармацевтична компанія або медичний центр: – Тип звіту: клінічне дослідження / регуляторний висновок / інструкція – Назва та код препарату – Регуляторна категорія – Дата документа і дата оновлення – Статус реєстрації
Банк або фінансова компанія: – Звітний період: квартал, рік – Фінансові метрики: P&L, баланс, кредитний портфель – Бізнес-сегмент або підрозділ – Географія: регіон або ринок – Статус: внутрішній / регуляторний / публічний
Як починати: 100–200 ключових термінів для вашого домену, що дозволяють однозначно класифікувати документи. З часом список розширюється на основі запитів, які не знаходять відповіді.
Провал №4 — Чистий семантичний пошук падає у спеціалізованих доменах
Реальна цифра: 15–20% failure rate
Семантичний пошук (semantic search) — основа більшості RAG-систем. Він перетворює запит і документи на числові вектори і шукає схожість між ними. Для загальних знань це працює добре. Але у спеціалізованих доменах — фармацевтика, медицина, право, фінанси — картина інша.
«Pure semantic search fails way more than people admit. In specialized domains like pharma and legal, I see 15-20% failure rates, not the 5% everyone assumes.»
15–20% запитів, на які система не знаходить правильної відповіді. Не тому що відповіді немає в документах — вона є. Але система не може її знайти через особливості семантичного пошуку.
Для більшості бізнес-задач 15–20% провалів — це занадто багато. Якщо менеджер у п’яти з двадцяти випадків отримує неправильну або порожню відповідь, він перестає довіряти системі і повертається до ручного пошуку.
Три головні failure modes
Acronym confusion (плутанина зі скороченнями). Те саме скорочення у різних контекстах означає різні речі, але має однакове векторне представлення. «ДКЗ» у банківській документації може означати «довгостроковий кредитний зобов’язання» і «державний казначейський зобов’язання» одночасно — і система не розрізняє ці значення.
Точні технічні запити. «Яке максимальне навантаження зазначено у специфікації моделі №XZ-447?» — семантичний пошук знаходить «схожі документи про навантаження», але не конкретну специфікацію з конкретним числом. Схожість за змістом не те саме, що точна відповідність.
Cross-reference chains (ланцюжки посилань). Документи посилаються один на одного. Регуляторна вимога посилається на галузевий стандарт, який посилається на технічну специфікацію. RAG-система, яка обробляє кожен документ окремо, не бачить цих зв’язків і не може відповісти на питання, відповідь на яке розподілена між кількома документами.
Hybrid retrieval як обов’язковий елемент
Рішення — гібридний підхід, який комбінує кілька методів пошуку:
- Семантичний пошук для загальних запитів
- Keyword-тригери для точних технічних запитів: якщо запит містить «номер», «специфікація», «таблиця», «дата» — система перемикається на точний пошук
- Graph layer (граф зв’язків між документами) для запитів, що потребують перехресних посилань
Це складніше у реалізації, але саме це відрізняє систему з 85% точністю від системи з 60–70% точністю.
Провал №5 — Таблиці: прихований кошмар RAG
Де зосереджена найкритичніша інформація
Таблиці — одна з найпоширеніших форм подання інформації в корпоративних документах. Фінансові показники по кварталах, дозування з клінічних досліджень, тарифні сітки, технічні специфікації, матриці відповідності регуляторним вимогам — все це оформлюється у вигляді таблиць.
І саме таблиці є найбільшою проблемою для стандартних RAG-систем.
Що відбувається зі стандартним підходом
Коли PDF-файл обробляється стандартним чином, таблиця витягується як неструктурований текст. Рядки і стовпці «розплескуються» в суцільний потік слів і чисел без збереження зв’язків між ними. Відповідь на запит «який показник у рядку 3, стовпці Q2» стає практично неможливою — адже у векторній базі зберігається текст «Назва показника 100 120 85 110», без розуміння що 100 відноситься до Q1, а 110 до Q4.
«The edge cases with enterprise documents will make you want to throw your laptop out the window. But when it works, the ROI is pretty impressive — seen teams cut document search from hours to minutes.»
Як обробляти таблиці окремо
Таблиці потребують власного пайплайну обробки. Практичний підхід:
Виявлення таблиць — за допомогою аналізу структури PDF (відстані між елементами, рядкові паттерни, сіткові структури). Таблиця не обробляється як звичайний текст.
Обробка простих таблиць — конвертація у структурований формат (CSV або JSON), де зв’язки між рядками і стовпцями збережені.
Обробка складних таблиць — додаткове збереження ієрархічних зв’язків: якщо таблиця містить підзаголовки або згруповані рядки, ці зв’язки зберігаються в метаданих.
Dual embedding (подвійне векторне представлення) — таблиця зберігається і як структурований запис, і як семантичний опис. Запит «яке дозування у дослідженні препарату X» знаходить таблицю через семантичний опис, а потім витягує конкретне значення через структурований запис.
Зв’язки між таблицями — зведені таблиці з деталізованими розбивками потребують явного зв’язку між собою, щоб запит на загальний показник міг «провалитись» до деталізованої таблиці при необхідності.
HR-відділи і компанії з кадрового аутсорсингу особливо відчувають цю проблему: персональні дані, грейди, тарифні сітки — все це зберігається у таблицях Excel або PDF, і без окремого пайплайну RAG-система практично марна для таких запитів.
Що це означає для вашого бізнесу — і з чого починати
Не всі компанії потребують enterprise RAG
RAG-система має сенс за певних умов. Якщо у вас менше 500 документів, вони чисті і добре структуровані, і запити від команди здебільшого прості — є простіші рішення, які дадуть кращий результат за менші кошти.
Enterprise RAG виправдовує себе коли:
- Документальна база велика і неоднорідна (різні формати, різна якість, різні роки)
- Домен спеціалізований: право, медицина, фінанси, технічна документація
- Запити від команди точні і вимагають конкретних даних, а не загальної інформації
- Документи часто оновлюються або поповнюються
Правильний порядок: спочатку аудит, потім архітектура, потім модель
Найпоширеніша помилка — починати з вибору AI-моделі. Правильний порядок зворотний:
Крок 1. Аудит документів. Які формати є у базі? Яка якість OCR? Чи є таблиці? Яка структура документів? Чи є скановані паперові документи? Відповіді визначають архітектуру.
Крок 2. Архітектура пайплайну. Скільки рівнів chunking потрібно? Яка схема метаданих відповідає вашому домену? Чи потрібен граф зв’язків між документами? Чи потрібен окремий пайплайн для таблиць?
Крок 3. Вибір і налаштування моделі. Тільки після двох попередніх кроків має сенс говорити про вибір embedding-моделі і LLM. До того часу питання «яку модель обрати» не має правильної відповіді.
Типовий обсяг роботи
Без конкретних цифр, але для орієнтиру: реалістичний enterprise RAG-проект з нуля займає кілька місяців, а не кілька тижнів. З них значна частина часу — підготовка документів і налаштування метаданих. Якщо вам обіцяють «RAG за тиждень» — це або спрощена система без урахування особливостей вашої документальної бази, або ілюзія, яка розвіється в перші дні реального використання.
Суттєва економія і реальна окупність системи, як правило, починається через 2–3 місяці після запуску — коли команда звикла до інструменту і починає справді покладатися на нього.
Як ми підходимо до RAG-проектів
Для проектів на базі корпоративної документації ми починаємо не з вибору технологій, а з document audit — аналізу вашої документальної бази. Результат аудиту: карта якості документів, орієнтовна схема метаданих для вашого домену і висновок про те, яка архітектура RAG-пайплайну підходить саме вам.
Тільки після цього ми проектуємо систему. Пілот займає 2–3 тижні, після чого у вас є робоча система на реальних документах — не на тестових прикладах.
Детальніше про наш підхід — на сторінці послуги AI-чатботів для бізнесу.
Часті питання
Якщо система добре працює на тестових прикладах, але погано на реальних документах — що не так?
Це класичний сигнал того, що система налаштована на «ідеальні» дані, але не на реальну корпоративну базу. Найчастіша причина — відсутність оцінки якості документів і single-size chunking. Тестові набори зазвичай складаються з чистих PDF без OCR-артефактів, таблиць і перехресних посилань. Реальна база — навпаки. Необхідний повноцінний аудит документів і, найімовірніше, переробка пайплайну обробки.
Чи потрібен власний IT-відділ для налаштування RAG?
Ні, але потрібен партнер з досвідом у RAG-проектах. Самостійне налаштування RAG на основі туторіалів приводить до системи, що «ніби працює» — і буде розчаровувати при реальному використанні. Ключова причина: туторіали не вчать вирішувати проблеми якості документів, метаданих і гібридного пошуку. Ці навички приходять тільки з досвідом реальних впроваджень.
Чи безпечно завантажувати конфіденційні документи в AI-систему?
Залежить від архітектури. Якщо система розгорнута в хмарі з використанням зовнішніх API — є ризики витоку даних. Для регульованих галузей (медицина, юриспруденція, фінанси) стандартом є on-premise розгортання: система розміщується на інфраструктурі клієнта і жодні дані не покидають периметр компанії. При проектуванні RAG-системи питання безпеки має розглядатися від початку, а не додаватися потім.
Як зрозуміти, що RAG реально покращився, а не просто «здається»?
Вимірювати результати потрібно конкретно: відсоток запитів з правильною відповіддю (за оцінкою реальних користувачів), середній час на пошук інформації до та після впровадження, кількість запитів, при яких система повернула «відповідь не знайдено» (і порівняти з попереднім тижнем). Суб’єктивне «здається краще» — не метрика. Базовий набір показників потрібно зафіксувати до запуску.
Скільки документів потрібно, щоб система дала результат?
Мінімальний поріг залежить від задачі. Для вузькоспеціалізованого завдання (наприклад, відповіді на питання за одним типом документів — типовими договорами або FAQ) достатньо кількох сотень документів. Для повноцінного корпоративного асистента, що охоплює різні типи документів і різні відділи, реалістичний мінімум — кілька тисяч документів. Важливіший не обсяг, а якість і однорідність бази.
Чи працює RAG українською мовою з кириличними документами?
Так, сучасні embedding-моделі підтримують кирилицю і добре справляються з українськими текстами. Є нюанс: деякі спеціалізовані терміни, що є суто українськими або є специфічними для законодавства України, можуть оброблятися гірше, ніж загальновживана лексика. Це вирішується через схему метаданих і keyword-словники, які враховують специфіку вашого домену. При побудові metadata-схеми для українського бізнесу важливо враховувати як українськомовні, так і англомовні версії термінів (регуляторна документація часто змішана).
Висновок
RAG-провали — це не технічна проблема. Це проблема розуміння того, де справді знаходяться вузькі місця. Більшість команд, які розчарувалися в AI-чатботі на базі документів, зробили одну і ту саму помилку: пропустили аудит якості документів, зробили метадані «по залишковому принципу» або скористалися першим-ліпшим туторіалом для чанкінгу.
Хороша новина: ці проблеми вирішувані. Команди, які правильно пройшли через document quality scoring, ієрархічний chunking і domain-specific метадані, бачать реальний результат — пошук інформації, що раніше займав години, займає хвилини.
Конкретний наступний крок: AI-аудит за 5 днів, у результаті якого ви отримаєте карту вашої документальної бази і висновок — де саме ламається або буде ламатися ваш RAG-пайплайн. Без аудиту будь-яка архітектурна рекомендація — це стрільба наосліп.