Це четверта стаття серії про побудову RAG-систем. У попередніх матеріалах ми розглянули, коли обирати RAG, а коли fine-tuning, як підготувати корпоративні документи і що враховувати при виборі між self-hosted і хмарним рішенням. Тепер — найважливіше питання після запуску: чи ваша система справді відповідає правильно?
Уявіть ситуацію: ваша компанія впровадила AI-асистента, який відповідає на питання менеджерів з продажів. Команда користується ним щодня. Усі задоволені — система швидко відповідає, інтерфейс зручний. Але одного дня ви дізнаєтеся, що асистент протягом двох тижнів давав хибні умови знижок — і десяток угод закрили за невигідними для компанії параметрами.
Система “відповідала”. Але відповідала неправильно.
Ця стаття — для власників і операційних директорів, які вже мають RAG-систему або стоять перед рішенням про впровадження. Ми розберемо, як оцінити якість без технічного освіти, які чотири метрики справді важливі, і дамо конкретний чеклист із 20 тестових питань, якими ви можете перевірити систему самостійно за годину.
Чому “вона відповідає” — ще не означає “вона відповідає правильно”
Більшість замовників оцінюють RAG-систему за одним критерієм: чи видає вона відповідь. Якщо система не “зависає” і не повертає помилку — значить, все добре. Це хибна логіка, і вона коштує бізнесу реальних грошей.
Три способи, якими RAG-система “зламується” непомітно
Перший — галюцинації. Система вигадує інформацію, якої немає в документах. Не через технічний збій, а через те, що мовна модель намагається “доповнити” неповну відповідь правдоподібними деталями. Менеджер отримує впевнену, граматично правильну відповідь — яка є повністю вигаданою.
Другий — знайдені “не ті” документи. Пошуковий блок RAG витягує з бази схожі за звучанням, але не релевантні фрагменти. Якщо ваш асистент відповідає на питання про умови договору підряду, але витягує з бази умови договору оренди — відповідь буде впевненою і неправильною одночасно.
Третій — неповнота. Система дає правильну, але неповну відповідь. Юрист питає про підстави для розірвання договору — система знаходить два з п’яти пунктів і відповідає впевнено. Три пункти залишаються невидимими. Рішення приймається на основі неповної картини.
Реальна статистика: 15–20% failure rate у спеціалізованих доменах
Є поширена помилка: що сучасні RAG-системи мають точність 90–95% і більше. Це правда для загальних, нескладних запитів. Але практики, які будують системи для фармацевтики, юридичних компаній, банків, фіксують зовсім інші цифри.
У спеціалізованих корпоративних доменах failure rate — тобто відсоток випадків, коли система дає хибну або неповну відповідь — складає 15–20%. Це не теоретична цифра: вона підтверджується багатьма реальними впровадженнями.
Що це означає на практиці? Якщо ваші 50 менеджерів звертаються до системи по 10 разів на день — це 500 запитів. З них 75–100 повернуть хибну або неповну відповідь. Щодня.
Тепер уявіть, що ці менеджери приймають рішення на основі цих відповідей: яку ціну назвати клієнту, які документи потрібні для угоди, які умови гарантії. Ціна кожної помилки — різна, але вона реальна.
Дві частини RAG — дві групи метрик
Щоб зрозуміти, як оцінювати якість, спочатку треба зрозуміти архітектуру. RAG — це не одна технологія, а дві, з’єднані разом.
Що таке retrieval і чому він важливіший за саму відповідь
Retrieval — це пошук. Коли ви ставите питання, перша частина системи “йде” в базу документів і витягує фрагменти, які, на її думку, стосуються питання. Це як помічник, якому ви кажете: “Знайди мені все про умови гарантії” — і він приносить стопку паперів із шафи.
Якщо помічник приніс не ті папери — все, що буде далі, побудоване на хибному фундаменті. Навіть найрозумніша мовна модель не зможе дати правильну відповідь на основі нерелевантних документів.
Саме тому якість retrieval — найважливіший параметр системи. Дві з чотирьох ключових метрик, які ми розберемо, стосуються саме цього блоку.
Що таке generation і де починаються галюцинації
Generation — це синтез відповіді. Після того як система зібрала релевантні фрагменти, мовна модель (GPT, Claude, Gemini або open-source аналог) читає їх і формулює відповідь людською мовою.
Проблема виникає, коли модель “вирішує допомогти” і додає інформацію, якої немає у витягнутих фрагментах. Вона робить це впевнено, граматично правильно — і без жодного попередження. Це і є галюцинація.
Метрика faithfulness якраз вимірює, наскільки відповідь “прив’язана” до реальних документів — і не виходить за їх межі.
Чотири метрики, які треба знати (простими словами)
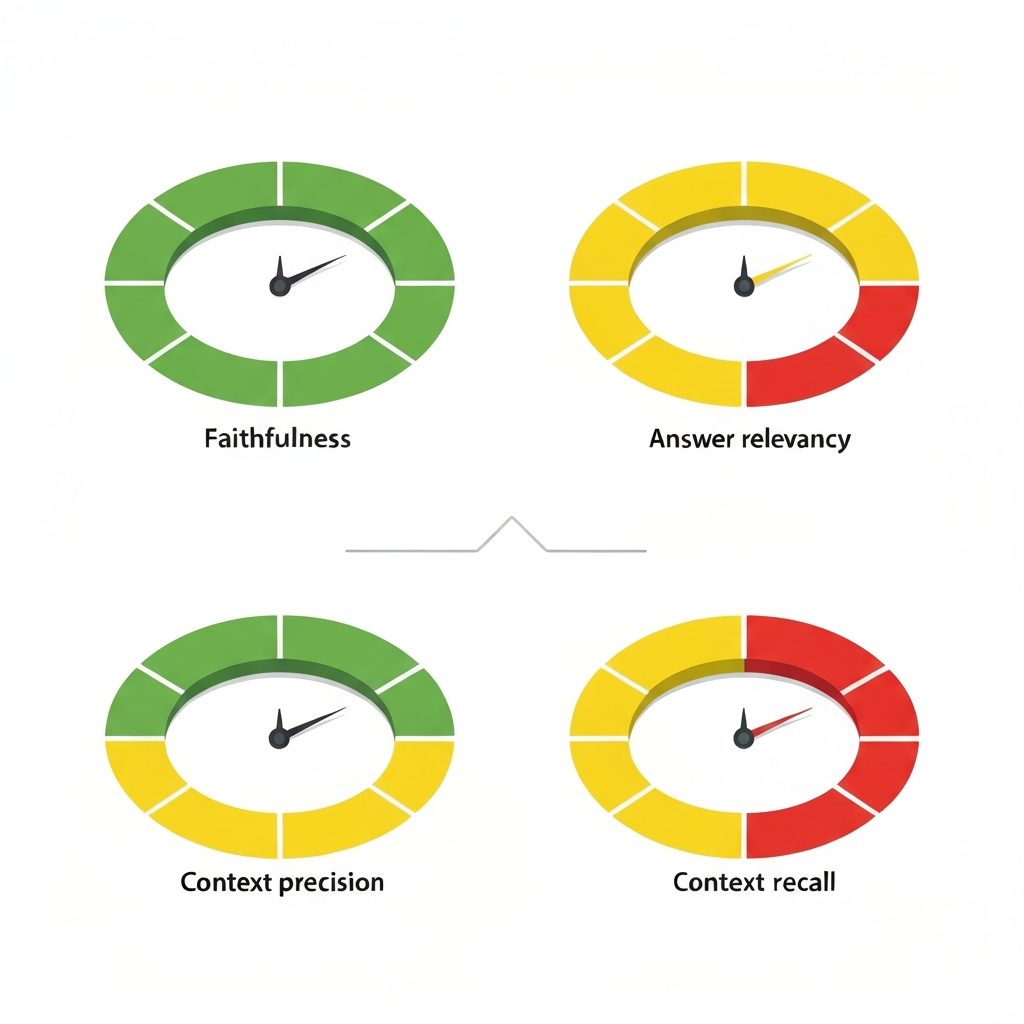
Технічна бібліотека RAGAS (про неї детальніше у наступному розділі) оперує десятками показників. Але для бізнес-оцінки достатньо чотирьох. Нижче — кожна метрика через аналогію, яка замінює формулу.
Faithfulness — “чи не вигадала система те, чого немає в документах?”
Faithfulness вимірює, наскільки кожне твердження у відповіді підкріплене реальним фрагментом із бази. Якщо система каже “гарантійний термін — 2 роки” — ця цифра має бути в документах. Якщо її там немає, а система впевнено її назвала — це провал по faithfulness.
Аналогія: уявіть бухгалтера, якому ви кажете: “Підготуй звіт на основі цих накладних”. Хороший бухгалтер бере цифри виключно з документів. Поганий — якщо чогось не вистачає, вписує “приблизно” або “десь читав”. Faithfulness вимірює, чи ваш AI-бухгалтер не вписує цифри з голови.
Практичний орієнтир: показник вимірюється від 0 до 1. Хороший результат — вище 0.85. Якщо faithfulness нижче 0.70 — система галюцинує регулярно: кожне п’яте-шосте твердження у відповіді вигадане. Нижче 0.60 — це вже серйозна проблема, яку не можна ігнорувати. На практиці це означає: кожне четверте твердження системи є вигаданим.
Answer Relevancy — “чи відповідає система саме на те, що питали?”
Answer Relevancy вимірює, наскільки відповідь відповідає конкретному питанню — а не “відповідає взагалі”. Система може дати правильну, технічно точну відповідь — але не на те питання, яке ставили.
Аналогія: ви питаєте менеджера з підтримки: “Яка процедура повернення товару?” Він відповідає: “Ми дуже цінуємо наших клієнтів і завжди прагнемо до найвищого рівня сервісу. Наша компанія існує 15 років і за цей час…” Відповідь правдива, але не на питання. Answer Relevancy вимірює, наскільки часто ваш AI-асистент дає таку “загальну” відповідь замість конкретної.
Практичний орієнтир: хороший показник — вище 0.80. Якщо нижче — система або “ухиляється” від точних відповідей, або витягує недостатньо специфічні фрагменти.
Context Precision — “чи знаходить система потрібні документи, а не шум?”
Context Precision оцінює якість пошуку: з усіх фрагментів, які система принесла для формування відповіді, скільки з них справді релевантні? Якщо система витягла 10 фрагментів, але 6 з них — зайвий “шум” — це низька precision.
Аналогія: уявіть Google-пошук, який на ваш запит “умови гарантії на ноутбук” видає 10 результатів, але 6 із них — реклама, форуми з нерелевантними темами і старі матеріали 2015 року. Ви, можливо, знайдете потрібне, але витратите більше часу і є ризик помилитися. AI-система з низькою precision так само “відволікається” на непотрібне — і будує відповідь на ненадійному фундаменті.
Практичний орієнтир: прийнятний рівень — вище 0.75. Низька precision часто означає, що база документів погано структурована або метадані не налаштовані під конкретний домен.
Context Recall — “чи не пропускає система важливу інформацію?”
Context Recall — зворотна сторона precision. Він вимірює: з усього, що мало б бути у відповіді, скільки система справді знайшла? Якщо є 5 важливих аспектів питання, а система знайшла лише 3 — recall складає 0.60.
Аналогія: ви наймаєте юриста перевірити договір і просите його зазначити всі ризикові пункти. Якщо юрист знайшов 3 з 5 — ви підпишете договір, не знаючи про два критичних ризики. Ви заплатили за повну перевірку, але отримали часткову. Система з низьким recall — це той самий юрист, який “забув” про важливі пункти.
Практичний орієнтир: хороший recall — вище 0.80. Низький показник часто вказує на проблеми з chunking (розбиттям документів на фрагменти) або з розміром бази знань.
RAGAS — що це і чи треба це знати власнику бізнесу?
Якщо ви зустрічаєте слово “RAGAS” у технічних обговореннях або у звіті підрядника — ось що за ним стоїть і що з цього потрібно знати саме вам.
RAGAS як “технічний інструментарій” — що він робить автоматично
RAGAS (Retrieval-Augmented Generation Assessment) — це open-source бібліотека для Python, яка автоматично вимірює якість RAG-систем. Розробники вводять тестові питання і очікувані відповіді — система автоматично розраховує описані вище метрики.
Це як стандартизований технічний аудит: замість того щоб вручну перевіряти сотні відповідей, RAGAS робить це автоматично за хвилини. Офіційна документація — на ragas.io.
Що з цього реально потрібно замовнику (без коду)
Для вас як замовника чи керівника важливо знати не як запустити RAGAS, а як читати його результати. Коли підрядник або команда надає звіт з оцінкою — ви маєте розуміти:
- Що означають числа (0 до 1 по кожній метриці)
- Що є прийнятним рівнем для вашого типу задач
- Які метрики критичніші для вашого use case (наприклад, для юридичної компанії faithfulness важливіший за все)
Просіть підрядника надати звіт RAGAS (або аналогічний) перед здачею системи і після кожного значного оновлення бази знань.
Альтернатива: LLM-as-a-Judge — коли одна AI оцінює якість іншої
Є ще один підхід, який набирає популярності: замість формульних метрик, одна велика мовна модель оцінює відповіді іншої. Ви ставите системі питання, вона відповідає — а потім GPT-4o або Claude читає питання, контекст і відповідь і виставляє оцінку за якістю.
Цей підхід менш точний формально, але більш гнучкий: він краще вловлює нюансні помилки, які формульні метрики пропускають. Хороші практики оцінки RAG поєднують обидва методи. Детально методологія описана на evidentlyai.com.
Практичний чеклист: 20 тестових питань, які перевірять вашу RAG-систему за 1 годину
Це зірковий блок статті — конкретний інструмент, який ви можете використати без жодних технічних знань. Все, що потрібно: доступ до системи і Excel.
Логіка тесту проста: ви ставите системі питання, де знаєте правильну відповідь, і порівнюєте. 20 питань розбиті на три категорії, кожна перевіряє різний аспект якості.
Питання категорії А — перевірка точності (чи є відповідь у документах?)
Ця категорія тестує faithfulness і answer relevancy. Беріть питання, відповідь на які точно є у ваших документах.
Тип 1 — Конкретні цифри і дати. Питання, де правильна відповідь є чітким числом або датою. Приклади: – “Яка тривалість гарантійного обслуговування для продукту X?” – “До якої дати діє договір з постачальником Y?” – “Яка мінімальна сума замовлення для безкоштовної доставки?”
Якщо система дає правильну цифру — добре. Якщо цифра відрізняється від документа — це галюцинація.
Тип 2 — Умови та процедури. Питання про конкретні правила і процеси: – “Яка процедура повернення бракованого товару?” – “Які документи потрібні для оформлення відрядження?” – “Хто має право підписувати договори на суму понад 100 000 грн?”
Тип 3 — Посилання на конкретний документ. Перевірте, чи система знаходить правильний документ: – “Що написано в пункті 4.2 договору з компанією Z?” – “Які умови описані в специфікації до замовлення №123?”
Питання категорії Б — перевірка повноти (чи не пропущено важливе?)
Ця категорія тестує context recall. Беріть питання, де правильна відповідь має кілька обов’язкових елементів.
Тип 4 — Переліки і списки. Питання, де відповідь — це набір пунктів: – “Які документи входять до пакету для реєстрації нового контрагента?” – “Які умови дають право на знижку?” – “Які кроки потрібно виконати при закритті проекту?”
Якщо у вашому регламенті є 5 документів, а система назвала 3 — recall низький.
Тип 5 — Питання з кількох аспектів. Питання, де є кілька правильних відповідей, залежно від умов: – “Як розраховується ціна для нових і постійних клієнтів?” – “Які терміни доставки при різних способах оплати?”
Тип 6 — Складні умовні питання. Питання “що якщо”: – “Що відбувається, якщо клієнт не сплатить протягом 30 днів?” – “Які наслідки, якщо підрядник зриває терміни більш ніж на тиждень?”
Питання категорії В — стрес-тест (а що, якщо питають “не так”?)
Ця категорія перевіряє стійкість системи до нестандартних запитів. Реальні користувачі не завжди формулюють питання правильно.
Тип 7 — Синоніми і розмовна мова. Те саме питання, іншими словами: – “Скільки чекати посилку?” (замість “які строки доставки?”) – “Чи можна повернути?” (замість “яка процедура повернення?”) – “Де взяти шаблон договору?” (замість “де знаходиться форма договору?”)
Тип 8 — Питання про те, чого немає в документах. Навмисно “не те” питання: – Запитайте про продукт, якого немає у вашому асортименті – Запитайте про процедуру, яка не описана в жодному документі – Запитайте про ціну на послугу з минулого року
Правильна відповідь системи: “Я не знайшов цієї інформації в доступних документах”. Небезпечна відповідь: система вигадує правдоподібну відповідь.
Тип 9 — Перехресні запити. Питання, що стосуються кількох документів одночасно: – “Яка загальна сума за квартал по всіх договорах з компанією X?” – “Чи є протиріччя між умовами договору і специфікацією?”
Як фіксувати результати: простий Excel-шаблон без програмування
Для кожного питання заповнюйте таблицю:
| Питання | Очікувана відповідь | Реальна відповідь системи | Оцінка (1–5) | Коментар |
|---|---|---|---|---|
| Яка тривалість гарантії на X? | 24 місяці (згідно з пунктом 3.1) | 24 місяці | 5 | Точно, з посиланням на документ |
| Яка тривалість гарантії на X? | 24 місяці | 18 місяців | 1 | Галюцинація — неправильна цифра |
| Які документи для реєстрації? | 5 документів (список) | 3 документи | 3 | Неповна відповідь, 2 пункти пропущені |
Шкала оцінки: – 5 — Точна повна відповідь, посилається на правильні документи – 4 — Правильна відповідь, але без точного посилання або з незначними неточностями – 3 — Частково правильна, але неповна – 2 — Суттєво неповна або містить неточності – 1 — Неправильна відповідь або галюцинація
Після тесту порахуйте середній бал. Нижче 3.5 — система потребує серйозного доопрацювання. Від 3.5 до 4.0 — є проблеми, але система частково працює. Вище 4.0 — задовільний рівень для більшості бізнес-задач.
Важливий нюанс: обов’язково тестуйте питання категорії В (що буде, якщо питають про те, чого немає). Система, яка на незнайоме питання впевнено видає вигадану відповідь — небезпечніша, ніж та, що чесно каже “не знаю”.
Сигнали тривоги: як розпізнати проблему без доступу до метрик
Метрики — це добре. Але що робити, якщо у вас немає доступу до дашборду RAGAS, а система вже в роботі? Є поведінкові сигнали, які говорять голосніше за будь-які числа.
Що говорять користувачі, коли RAG погано працює
Зверніть увагу на такі фрази від колег і менеджерів, які користуються системою:
- “Я краще сам перевірю в оригінальному документі” — це означає, що люди перестали довіряти системі і використовують її лише як відправну точку, а не як відповідь.
- “Вона іноді дає різні відповіді на одне й те саме питання” — нестабільність відповідей є ознакою поганого retrieval: система щоразу знаходить різні фрагменти.
- “Відповідь правильна, але не зовсім те, що я питав” — класичний симптом низького answer relevancy.
- “Система написала X, але в договорі написано Y” — явна галюцинація або помилка в базі документів.
Якщо ви чуєте хоча б один із цих коментарів регулярно — це сигнал для перевірки.
Поведінкові патерни: коли люди перестають довіряти системі
Є ще більш тривожний сигнал — коли люди перестають говорити про проблеми і просто перестають користуватися системою. Відслідкуйте:
- Падіння кількості запитів — якщо через місяць після впровадження активність знизилася з 200 до 80 запитів на день, це не тому що питань стало менше.
- Зростання “обхідних шляхів” — якщо менеджери знову масово телефонують одне одному замість питання AI-асистента.
- Відмова від використання у важливих питаннях — якщо система використовується для дрібниць, але не для серйозних рішень.
Ці патерни кажуть: система не пройшла неформальний “тест на довіру” у команди.
Три “червоні прапори” від операційних директорів, які вже пройшли через це
Червоний прапор перший: система “впевнена” навіть тоді, коли має бути невпевнена. Якщо ви ставите питання про щось, чого точно немає в базі документів, а система все одно дає детальну відповідь — це катастрофа в продуктивному середовищі.
Червоний прапор другий: відповіді звучать правдоподібно, але не можна перевірити джерело. Якщо система не вказує, з якого документа взята відповідь — у вас немає способу перевірити її правильність без самостійного пошуку. Це зводить цінність системи до нуля.
Червоний прапор третій: система добре відповідає на тестових прикладах, але погано — на реальних питаннях. Цей розрив трапляється, коли систему тестували на “ідеальних” питаннях, але не перевіряли на реальних запитах від живих користувачів, які формулюють по-різному.
Що робити, якщо результати тестування незадовільні?
Отримали низькі бали в тесті — не поспішайте переробляти все з нуля. Різні проблеми мають різні рішення, і більшість із них виправляється без кардинальної перебудови.
Faithfulness низька — проблема в LLM або в документах?
Якщо система регулярно “вигадує” — є дві причини. Перша: документи в базі застарілі, суперечливі або неповні — і система “доповнює” прогалини. Друга: мовна модель налаштована занадто “творчо” і схильна до генерації поза наданим контекстом.
Практичний крок: перевірте базу документів на наявність застарілих або суперечливих матеріалів. Попросіть технічну команду знизити параметр “temperature” мовної моделі — це зменшує схильність до вигадування.
Context Precision низька — час переглянути якість бази знань
Якщо система знаходить багато нерелевантних фрагментів — найчастіша причина: документи в базі погано структуровані або змішані матеріали різної тематики без чіткого розмежування.
Практичний крок: зробіть аудит бази — чи є в ній документи, що не стосуються поточних задач? Чи правильно налаштовані метадані документів (дата, тип, відділ)? Погані метадані — це 40% проблем з retrieval, і це виправляється без переписування системи.
Context Recall низька — потрібно переналаштувати chunking або metadata
Якщо система не знаходить всю потрібну інформацію — найчастіше це проблема chunking: документи розбиті на занадто великі або занадто малі фрагменти. Або важлива інформація розподілена по кількох документах без зв’язків між ними.
Практичний крок: попросіть технічну команду перевірити налаштування розбиття документів і перевірити, чи є в системі можливість “прив’язувати” пов’язані документи один до одного.
Коли варто звернутися до фахівців, а коли можна виправити самостійно
Виправляйте самостійно (з командою): – Оновлення та очищення бази документів — це не технічна, а контентна задача – Перевірка актуальності матеріалів і видалення застарілих – Узгодження термінології в документах
Зверніться до фахівців: – Якщо після очищення бази faithfulness залишається нижче 0.70 – Якщо різні типи запитів дають кардинально різну якість – Якщо потрібно переналаштувати chunking або архітектуру retrieval – Якщо потрібна автоматична метрична оцінка, а не ручний тест
Хороший підрядник не просто “щось підкручує” — він надає звіт до і після зміни з конкретними числами метрик. Якщо вам відмовляють у такому звіті — це погана ознака.
Скільки коштує погано налаштована RAG-система?
Це питання, яке рідко ставлять прямо — але воно визначає, чи варто взагалі займатися оцінкою якості.
Розберемо конкретну математику. Візьмемо компанію, де 50 менеджерів щодня використовують RAG-систему для відповідей на питання клієнтів, пошуку умов договорів і підготовки комерційних пропозицій.
Кожен менеджер звертається до системи 10–15 разів на день. При failure rate 15–20% — тобто при середньому рівні для спеціалізованих систем — від 75 до 150 запитів на день повертають хибну або неповну відповідь.
Тепер порахуємо в грошах. Якщо завантажена вартість одного менеджера (зарплата плюс накладні) — приблизно 500 грн на годину, і кожна помилка системи коштує в середньому 20 хвилин додаткового часу на перевірку і виправлення — це 150 грн за помилку. При 100 помилках на день — 15 000 грн щоденно на виправлення наслідків.
Але є ще важливіші втрати. Якщо менеджер назвав клієнту неправильні умови знижки або помилкові строки — це не просто витрати часу. Це потенційно невигідна угода, конфлікт з клієнтом або репутаційна шкода. Ці витрати важко порахувати, але вони реальні.
Формула для вашого розрахунку: (кількість співробітників) × (середня кількість запитів на день) × (failure rate 0.15-0.20) × (вартість однієї помилки в годинах × вартість години) = щоденні витрати на неякісний RAG.
І ось контраргумент: повноцінний аудит RAG-системи, налаштування та переналаштування — займає від кількох тижнів і коштує в рази менше, ніж місяці роботи в режимі 15–20% помилок.
Зв’язок із попередньою статтею: ми вже розглядали різницю між self-hosted і хмарними RAG-рішеннями. Важлива деталь: якість retrieval залежить не від того, де розгорнута система, а від того, як налаштована база документів і метадані. Self-hosted система з поганою якістю документів дасть гірший результат, ніж хмарна з правильно підготовленою базою. Інфраструктура не компенсує проблеми з контентом.
Підсумок і наступний крок
Якість RAG-системи — не технічне питання. Це бізнес-питання, відповідь на яке безпосередньо впливає на рішення, які приймає ваша команда щодня.
Чотири метрики, які варто відслідковувати: faithfulness (чи не вигадує система), answer relevancy (чи відповідає на питання), context precision (чи знаходить потрібні документи) і context recall (чи не пропускає важливе). Хороша система матиме всі чотири показники вище 0.80.
Чеклист 20 питань — це найпростіший спосіб отримати першу оцінку якості без технічних знань і спеціальних інструментів. Один менеджер, одна година, Excel — і ви вже маєте реальну картину.
Що зробити цього тижня:
- Відкрийте вашу RAG-систему і поставте 5–7 питань із категорії А (конкретні цифри, де ви знаєте правильну відповідь).
- Зафіксуйте результати в таблиці.
- Запитайте підрядника: “Який показник faithfulness і context recall у нашій системі по останньому вимірюванню?”
Якщо підрядник не може відповісти на третє питання — це вже інформація для рішення.
Наступна стаття серії буде присвячена вартості впровадження RAG: як скласти бюджет, де найчастіше помиляються при оцінці і яка реальна структура витрат для компаній 20–200 осіб в Україні.
Часті питання
Чи можна оцінити RAG-систему без доступу до технічних метрик?
Так. Чеклист 20 тестових питань із цієї статті дає змогу оцінити якість вручну — без Python, без RAGAS і без доступу до внутрішнього дашборду. Результати менш точні, ніж автоматизоване вимірювання, але достатні, щоб зрозуміти: є критична проблема чи ні.
Що таке нормальний рівень faithfulness для бізнес-застосування?
Прийнятний рівень — вище 0.85. При показнику 0.70–0.85 система працює, але регулярно галюцинує, і важливі рішення потребують додаткової перевірки. Нижче 0.70 — система в поточному стані не придатна для прийняття рішень без постійного контролю людини.
Чи достатньо перевірити систему один раз при впровадженні?
Ні. Якість RAG-системи змінюється зі змінами в базі документів. Кожного разу, коли ви оновлюєте або додаєте значний обсяг документів, варто проводити повторний тест. Мінімальна частота для активно використовуваних систем — раз на квартал.
Як зрозуміти, що проблема в документах, а не в технології?
Зробіть тест: поставте питання, відповідь на яке є в конкретному, добре написаному документі — і одразу знайдіть цей документ вручну. Якщо документ існує і чітко написаний, але система не знаходить відповіді — проблема технічна (retrieval або chunking). Якщо документ є, але написаний нечітко або суперечить іншим матеріалам — проблема в якості бази знань.
Чи потрібна спеціальна команда для оцінки якості RAG?
Для базового тестування — ні. Будь-який менеджер, який знає вміст ваших документів, може провести тест за чеклистом. Для систематичного моніторингу з автоматичними метриками потрібна технічна команда або підрядник. Ми пропонуємо безкоштовний AI-аудит, який включає оцінку faithfulness, precision і recall із звітом за 5 робочих днів.
Що таке “галюцинація” у RAG-системі і чи можна її повністю усунути?
Галюцинація — це коли система генерує інформацію, якої немає в базі документів. Повністю усунути її неможливо при нинішньому стані технологій, але можна суттєво знизити: правильним налаштуванням параметрів моделі, якісною базою документів і архітектурою, яка змушує систему “тримати” відповідь у межах наданого контексту. Хороша система повинна також чесно відповідати “не знаю”, коли відповіді в документах немає.
Чи варто автоматизувати оцінку якості RAG?
Якщо система використовується активно (сотні запитів на день), автоматизація необхідна — ручний тест не дасть систематичної картини. Якщо система невелика і запитів небагато — щоквартальний ручний тест достатній для початку.
Маєте сумніви щодо якості вашої поточної RAG-системи? Або плануєте впровадження і хочете одразу зробити правильно? Замовте безкоштовний AI-аудит — протягом 5 робочих днів ви отримаєте звіт з оцінкою faithfulness, context precision і recall, а також конкретні рекомендації. Або ознайомтеся з нашою послугою автоматизації документообігу, якщо питання якості RAG пов’язане з підготовкою та структуруванням корпоративних документів.