Менеджер Олексій щойно отримав дзвінок від клієнта, з яким не спілкувався пів року. Клієнт запитує: «Яку знижку ви нам давали в тій комерційній пропозиції?». Олексій лізе в CRM, але там тільки короткий запис «відправлено КП». Лист у Gmail десь у 300 повідомленнях від тієї ж компанії. PDF-пропозиція — десь у папці на диску. Клієнт чекає.
Така ситуація відбувається в десятках компаній щодня. Дані є — вони розкидані по CRM-картці, email-ланцюжках і вкладених файлах. Знайти потрібний фрагмент за 30 секунд без RAG практично неможливо.
RAG (Retrieval-Augmented Generation) для CRM вирішує саме це: менеджер пише запит звичайною мовою, AI знаходить потрібні дані з усіх підключених джерел і повертає відповідь з посиланням на джерело — за 2–3 секунди. Ця стаття пояснює, як це працює технічно, як виглядає в реальному діалозі, чим відрізняється підключення до KeyCRM, NetHunt і Bitrix24, і де у RAG є чесні обмеження, про які рідко говорять.
Якщо ви ще не знайомі з базовою архітектурою RAG, рекомендуємо почати з нашої статті про RAG-архітектуру для бізнесу. Якщо стоїть питання RAG чи дообучення моделі — є окреме порівняння RAG і fine-tuning.
Що болить у відділі продажів без AI
Менеджер шукає — клієнт чекає
Відділ продажів B2B-компанії на 30–150 осіб — це, як правило, суміш трьох-чотирьох систем, між якими ніхто не ходить автоматично. CRM тримає картки клієнтів і статуси угод. Gmail або корпоративна пошта — переписку. Google Drive або OneDrive — комерційні пропозиції, договори, специфікації. І ще є нотатки в Notion або просто в Teams-чаті, куди менеджер кинув ключову інформацію після дзвінка.
Коли клієнт дзвонить і запитує «де наш підписаний договір?» або «яка ціна була в тій пропозиції?» — менеджер починає паралельний пошук у чотирьох вікнах. Середній час пошуку по нашому досвіду — 5–12 хвилин на один запит. При 10–15 таких запитах на день у менеджера йде до 2 годин тільки на пошук даних. Це не перебільшення: дослідження компанії TP ICAP (один із найбільших міжброкерів у світі) показало, що інтеграція RAG з Salesforce скоротила час на ресерч по клієнтах на 75% — і це при базі в десятки тисяч записів зустрічей і угод.
Три джерела хаосу: картки CRM, PDF-договори, email-ланцюжки
Проблема не в тому, що даних немає. Проблема в тому, що вони існують у трьох форматах, між якими немає зв’язку.
Картки CRM містять структуровані дані: назва компанії, контактна особа, сума угоди, статус, тег. Це таблиця — її можна фільтрувати і сортувати. Але вона не містить контексту: чому клієнт пішов, що саме обіцяв менеджер, яка деталь переговорів стала вирішальною.
Нотатки і записи комунікацій — це напівструктуровані дані. Хтось пише детально, хтось залишає «дзвонив, домовились». Ці записи часто є в CRM, але їх не можна знайти звичайним пошуком по полях.
PDF-договори, комерційні пропозиції, листування — повністю неструктуровані дані. CRM зберігає посилання або вкладення, але прочитати, що написано всередині файлу, без відкриття — неможливо. Пошук по вмісту PDF в більшості CRM відсутній взагалі.
RAG — це перша технологія, яка дозволяє одночасно шукати по всіх трьох форматах і повертати відповідь, склеєну з різних джерел, в один зв’язний текст.
Що таке RAG і чим він відрізняється від «звичайного» чат-бота в CRM
RAG простими словами: пошук + генерація
RAG — це двоетапний процес. Перший етап: система отримує ваш запит і шукає в базі векторно проіндексованих документів найближчі за змістом фрагменти. Другий: ці фрагменти передаються мовній моделі разом із запитом, і модель формулює відповідь, спираючись на знайдені дані.
Ключова відмінність від звичайного пошуку: ви не шукаєте за ключовими словами, а описуєте ситуацію людською мовою. «Яка знижка була в нашій пропозиції для ТОВ “Ромашка” восени?» — система знаходить потрібний PDF-файл, витягує потрібний рядок і повертає: «У комерційній пропозиції від 12 вересня 2025 для ТОВ “Ромашка” вказана знижка 12% на партію від 500 одиниць».
Детальніше про те, як підготувати документи для RAG-системи, читайте в статті про підготовку корпоративних документів для RAG.
Чому вбудований AI Bitrix24 / KeyCRM не те саме
Більшість сучасних CRM мають вбудовані AI-функції. Bitrix24 пропонує AI-підказки в чаті, KeyCRM — автоматичне заповнення полів. Але це не RAG.
Вбудований AI у CRM, як правило: – Аналізує тільки відкритий запис або конкретну угоду — не всю базу – Не читає вміст вкладених файлів, тільки метадані – Не бачить email-листування, якщо воно не синхронізоване в CRM – Не може відповісти на питання «порівняй всі наші пропозиції для цього клієнта за 2 роки»
RAG-інтеграція — це окремий шар над CRM, який підключається до всіх джерел даних і дозволяє ставити питання по всій базі, а не по одній картці.
Коли RAG потрібен, а коли — зайвий
RAG виправданий, якщо у вашому відділі продажів виконується хоча б дві з цих умов:
- База клієнтів від 200+ контактів, і менеджери регулярно шукають старі угоди
- Є накопичені договори, КП або листування, яке важливо знаходити швидко
- Онбординг нових менеджерів займає місяці через необхідність «знати базу»
- Клієнти часто посилаються на попередні домовленості, які треба підтвердити
RAG зайвий, якщо у вас 30–50 клієнтів, стандартні угоди без індивідуальних умов і CRM використовується тільки як адресна книга.
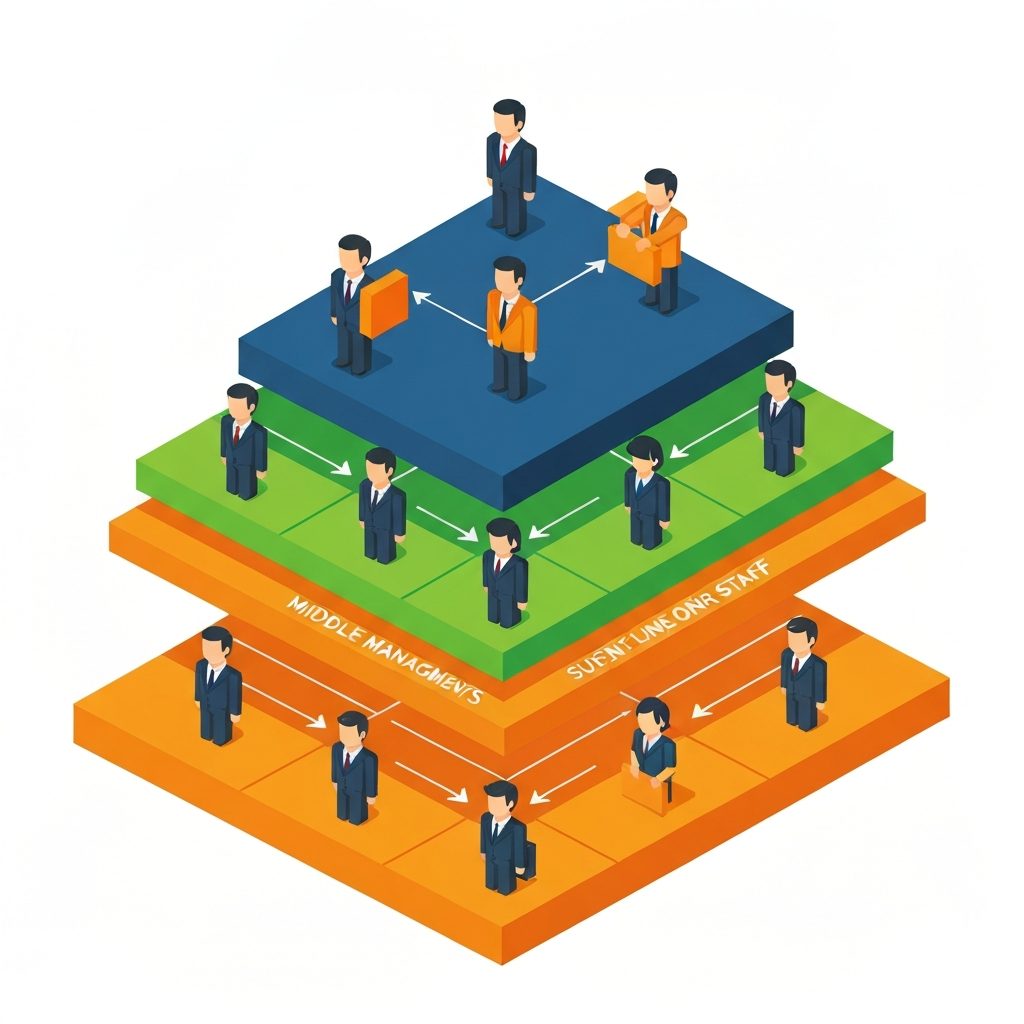
Як RAG читає дані вашої CRM: три шари
Шар 1 — структуровані поля картки (ім’я, сума угоди, статус)
Це найпростіший шар для RAG. Поля CRM — назва компанії, сума, статус угоди, відповідальний менеджер, дата — перетворюються на текстові документи і індексуються у векторній базі.
Приклад: поле картки «Сума угоди: 450 000 грн, статус: виграна, дата закриття: 15.01.2026» стає фрагментом тексту, який RAG може знайти за запитом «яка угода з Укрпостачем закрилась на початку року».
Обмеження цього шару: RAG тут може замінити фільтрацію, але не перевершить її. Якщо вам потрібно «покажи всіх клієнтів з боргом понад 100K» — це запит до бази даних, а не до RAG (про це детальніше в розділі про обмеження).
Шар 2 — записи комунікацій і нотатки менеджерів
Це де RAG справді виграє порівняно зі стандартним пошуком. Нотатки після дзвінків, записи задач, коментарі в угодах — весь цей текст індексується і стає доступним для семантичного пошуку.
Менеджер пише: «що ми обговорювали з Ковальчук Оленою в жовтні щодо терміну оплати». RAG знаходить нотатку «Клієнт просила відтермінування 30 днів, підтвердили письмово, угода на умові передоплати 50%» — навіть якщо менеджер не пам’ятає ні дати, ні точних формулювань.
Шар 3 — вкладення: PDF-договори, комерційні пропозиції, листування
Це найбільш цінний і найбільш технічно складний шар. PDF-файли, прикріплені до карток CRM, або email-листування, синхронізоване з CRM, обробляються окремим пайплайном: текст витягується, розбивається на фрагменти (chunking), і кожен фрагмент отримує векторне представлення.
Важливий нюанс: якість обробки PDF прямо залежить від якості самих файлів. Скановані договори без OCR-шару або файли з нечитабельними таблицями дадуть поганий retrieval. Договори, збережені в текстовому форматі, опрацьовуються добре. Якщо ваш архів договорів — здебільшого скани від нотаріуса, перед RAG-інтеграцією потрібен етап OCR-очищення.
Про специфіку підготовки різних типів корпоративних документів читайте в нашій статті про підготовку документів для RAG.
Практичний сценарій — KeyCRM + RAG: як це виглядає у менеджера
Запит «що ми пропонували ТОВ Ромашка шість місяців тому»
Менеджер відкриває чат-інтерфейс (Telegram-бот, вікно в CRM або окремий чат). Набирає:
Менеджер: що ми пропонували ТОВ “Ромашка” навесні? яка була ціна і умови?
Через 2–3 секунди:
AI-асистент: У квітні 2025 для ТОВ “Ромашка” (менеджер Петренко І.) була відправлена комерційна пропозиція №КП-2025-047.
Умови: постачання обладнання XR-500 (3 одиниці) за ціною 87 000 грн/одиниця, разом 261 000 грн без ПДВ. Знижка 8% від прайсу. Термін постачання — 21 робочий день. Гарантія 24 місяці.
Оплата: передоплата 30%, решта при отриманні. Пропозиція дійсна 30 днів — тобто термін дії закінчився 15 травня 2025.
Джерело: файл КП-2025-047.pdf, прикріплений до угоди №1134 у KeyCRM.
Що система зробила під капотом:
- Запит менеджера перетворено на вектор (embedding) — числове представлення змісту запиту.
- У векторній базі (наприклад, Qdrant або Weaviate) виконано пошук по найближчих векторах серед усіх проіндексованих фрагментів, пов’язаних з ТОВ “Ромашка”.
- Знайдено три найрелевантніші фрагменти: картка угоди №1134, нотатка менеджера про відправлення КП, і текст самого PDF-документа КП-2025-047.
- Всі три фрагменти передані до мовної моделі як контекст разом із запитом.
- Модель сформулювала відповідь, склавши дані з трьох джерел, і додала посилання на джерело.
Весь процес — 2–3 секунди. Менеджер Олексій знайшов би це вручну за 8–15 хвилин.
Запит «коли закінчується договір з партнером і яка сума»
Ще один типовий сценарій — контроль договорів. Менеджер запитує:
Менеджер: коли закінчується договір з ПП Сучасні Технології і яка там річна сума?
AI-асистент: Договір №ДГ-2024-019 з ПП “Сучасні Технології” (підписаний 01.03.2024) діє до 28.02.2027 — залишається ще 21 місяць.
Річна сума за договором: 1 200 000 грн (без ПДВ), виставляється квартальними рахунками по 300 000 грн.
Останній рахунок №Р-2026-031 виставлено 01.04.2026, статус: оплачено 15.04.2026.
Джерело: договір ДГ-2024-019.pdf + картка угоди №892 у KeyCRM.
Такий запит менеджер міг би закрити через: відкрити картку клієнта → знайти прикріплений договір → відкрити PDF → знайти потрібну сторінку → перевірити статус останнього рахунку. Час: 5–10 хвилин. З RAG — 3 секунди.
Що відбувається під капотом: від питання до відповіді за 2–3 секунди
Весь процес RAG-запиту проходить через чотири технічні кроки, але важливо розуміти їх для правильних очікувань:
1. Embedding запиту. Текст питання перетворюється на вектор числових значень — «цифровий відбиток» змісту. Це займає ~50–100 мілісекунд.
2. Vector search. Векторна база порівнює вектор запиту з мільйонами збережених векторів документів і повертає топ-5–10 найближчих за змістом фрагментів. При правильній інфраструктурі — ~100–300 мілісекунд навіть на великих базах.
3. Context assembly. Знайдені фрагменти збираються у prompt для LLM разом із запитом і системними інструкціями (наприклад, «відповідай тільки на основі наданих даних, вказуй джерело»).
4. LLM generation. Мовна модель генерує відповідь. При використанні API-моделей (OpenAI GPT-4o, Gemini) — ще 1–2 секунди. При self-hosted моделі на GPU сервері — залежить від потужності.
Загальний час: 2–4 секунди для стандартних запитів.
Bitrix24, NetHunt, KeyCRM — як підключають RAG у 2025–2026
Три найпопулярніші CRM в українському B2B мають суттєво різну архітектуру, і це прямо впливає на складність RAG-інтеграції. Нижче — практичне порівняння.
| Параметр | Bitrix24 | NetHunt CRM | KeyCRM |
|---|---|---|---|
| Архітектура | Монолітна хмара/коробка, REST API | Gmail-embedded, повна інтеграція з Google Workspace | SaaS, відкритий REST API |
| Доступ до даних через API | Так, але rate limits і складна схема сутностей | Так, через Google-токен + власний API | Так, зручний API з документацією |
| Email-листування | Зберігається всередині, доступне через API | Нативно: листи в Gmail = записи в NetHunt | Частково: треба налаштовувати синхронізацію |
| PDF-вкладення | Зберігаються в Bitrix24 Drive | Google Drive (автоматично, якщо використовуєте Gmail) | Зберігаються на серверах KeyCRM, завантажуються через API |
| Готові RAG-шаблони | n8n-шаблон: Qdrant + Gemini для Open Line | Немає готового, але Google Cloud RAG Engine сумісний | Немає готового, гнучке API дозволяє кастомну інтеграцію |
| Складність підключення RAG | Середня (є шаблон, але кастомізація потрібна) | Висока (специфічна Google-архітектура) | Середня (просте API, але немає шаблону) |
| On-premise варіант | Так (коробкова версія) | Ні | Ні |
| Типовий термін інтеграції RAG | 4–6 тижнів (з шаблону) | 6–10 тижнів | 4–8 тижнів |
| Орієнтовний бюджет пілоту | 80–150 тис. грн | 100–180 тис. грн | 70–130 тис. грн |
Bitrix24: готовий n8n-шаблон (Qdrant + Gemini) для Open Line
Bitrix24 має відносно розвинуту екосистему інтеграцій. На ринку є n8n-шаблони (n8n — платформа автоматизації з відкритим кодом), які підключають Bitrix24 Open Line до RAG-пайплайну через Qdrant (векторна база) і Gemini (LLM від Google).
Як виглядає архітектура: n8n-workflow слухає нові повідомлення в Open Line → витягує контекст угоди через Bitrix24 REST API → шукає релевантні фрагменти в Qdrant → передає запит і контекст до Gemini → повертає відповідь в чат.
Що важливо знати: шаблон покриває тільки чат Open Line. Для індексації PDF-договорів зі сховища Bitrix24, нотаток в задачах і CRM-коментарів — потрібна додаткова кастомізація, яка зазвичай займає 2–4 тижні понад базовий шаблон.
Для коробкової версії Bitrix24 є перевага: можливість self-hosted RAG, де жодні дані не виходять за межі вашої інфраструктури. Це важливо для компаній з підвищеними вимогами до конфіденційності клієнтських даних.
NetHunt: Gmail-контекст і email-ланцюжки як джерело RAG
NetHunt — унікальна CRM у тому, що вона живе всередині Gmail. Кожен лист автоматично прив’язується до картки клієнта. Це і перевага, і складність.
Перевага: email-листування вже організоване навколо контактів і угод — не треба синхронізувати окремо. Якщо підключити RAG до Google Drive (де зберігаються прикріплені файли) і до NetHunt API — ви отримуєте RAG по всьому ланцюжку комунікацій одразу.
Складність: архітектура завязана на Google OAuth і специфічну схему авторизації. Google Cloud пропонує власний RAG Engine (Vertex AI RAG), який природньо працює з Google Workspace. Але налаштування вимагає досвіду роботи з GCP і може виявитися дорожчим за альтернативи.
Типовий стек для NetHunt RAG: Google Cloud Storage → Document AI (OCR для PDF) → Vertex AI Embeddings → Vertex AI RAG Engine → NetHunt API для контексту угоди.
KeyCRM: API-підключення і вибір векторної бази
KeyCRM — найбільш «відкрита» з трьох у плані API-доступу до даних. Документація чітка, ендпоінти покривають угоди, контакти, нотатки, вкладення і активності.
Для RAG-інтеграції з KeyCRM типовий пайплайн: 1. Sync-скрипт або n8n-workflow регулярно (наприклад, кожні 4 години) витягує нові та оновлені записи через KeyCRM API. 2. Текст нотаток, коментарів і витягнутий текст PDF-вкладень дроблять на фрагменти і індексують у векторній базі (Qdrant, Weaviate або Chroma). 3. Telegram-бот або веб-чат приймає запити менеджерів, виконує vector search і повертає відповідь.
Відсутність готового шаблону компенсується простотою API: досвідчена команда збирає базову інтеграцію за 2–3 тижні, кастомізацію під конкретні сценарії — ще 2–4 тижні.
Детальніше про те, як підключити різні CRM-системи до AI-інструментів читайте в матеріалі про AI-інтеграції з KeyCRM, NetHunt і Bitrix24.
Що RAG не вирішить у вашій CRM — чесно про обмеження
Синхронізація в реальному часі: проблема свіжості даних
RAG не бачить дані «зараз». Він бачить стан індексу на момент останньої синхронізації.
Якщо менеджер тільки-но оновив нотатку в CRM-картці, і синхронізація відбувається раз на 4 години — ця нотатка з’явиться в RAG тільки через 4 години. Для більшості запитів «знайди старі дані» це не проблема. Але якщо хтось запитує «який статус угоди з компанією X зараз» — є ризик отримати застарілу інформацію.
Рішення: для полів, де важлива актуальність в реальному часі (статус угоди, баланс, етап воронки), краще робити прямий API-запит до CRM, а не покладатися на RAG-індекс. Добре спроектована система RAG для CRM поєднує обидва підходи: RAG для семантичного пошуку по документах і нотатках, прямий API — для актуальних структурованих полів.
Аналітичні запити — це не RAG, це Text-to-SQL
Одна з найпоширеніших помилок при впровадженні RAG у відділі продажів — намагання замінити ним CRM-аналітику.
RAG не відповість правильно на запити типу: – «Покажи всіх клієнтів з простроченою дебіторкою понад 30 днів» – «Скільки угод закрив Петренко у Q1 2026» – «Які клієнти не платили більше 3 місяців»
Це аналітичні запити до структурованих даних. Для них правильний підхід — Text-to-SQL: AI перетворює питання на SQL-запит і виконує його проти бази даних CRM. Деякі CRM (Salesforce, великий Bitrix24) вже мають вбудовані Text-to-SQL або NL2SQL функції, або їх можна додати окремим шаром.
RAG і Text-to-SQL — не конкуренти, вони доповнюють одне одного. RAG — для «знайди мені контекст, що ми обговорювали». Text-to-SQL — для «порахуй, скільки і де».
«Вигадки» моделі: як мінімізувати галюцинації
LLM-модель може «галюцинувати» — генерувати впевнено сформульовану відповідь, яка не відповідає реальним даним у документах. У CRM-контексті це особливо небезпечно: менеджер може отримати неправильну суму знижки або дату договору і передати її клієнту.
Три практичних способи мінімізувати цей ризик:
1. Grounding з джерелом. Кожна відповідь повинна містити посилання на конкретний документ/фрагмент. Якщо AI не знайшов відповідний фрагмент з достатньою релевантністю — він відповідає «не знайдено у базі», а не вигадує.
2. Confidence threshold. Система повертає відповідь тільки якщо relevance score знайдених фрагментів перевищує заданий поріг (наприклад, 0.75 з 1.0). При нижчому score — запит ескалюється людині.
3. Системна інструкція. LLM отримує чіткий промпт: «відповідай тільки на основі наданих фрагментів. Якщо відповіді немає у наданих даних — прямо скажи “інформація не знайдена в базі”».
При правильному налаштуванні всіх трьох механізмів рівень галюцинацій у виробничій RAG-системі знижується до прийнятного рівня. Детальніше про причини неправильних відповідей і як їх виправляти — в статті чому RAG дає неправильні відповіді.
Безпека: де залишаються дані клієнтів
Питання безпеки — перше, яке ставлять власники бізнесу і юридичний відділ. «Чи не потраплять дані наших клієнтів до OpenAI?»
Cloud RAG vs self-hosted: що вибрати під UA-умови
Є дві базові архітектурні моделі:
Cloud RAG (наприклад, OpenAI embeddings + Pinecone векторна база + GPT-4o як LLM): документи ваших клієнтів проходять через зовнішні сервери для створення векторів і генерації відповідей. OpenAI за умовами API не навчає моделі на ваших даних, але самі запити проходять через їхню інфраструктуру.
Self-hosted RAG: векторна база (Qdrant, Weaviate, Milvus) розгортається на вашому сервері або в приватному хмарному середовищі (наприклад, AWS VPC). Embedding-модель (наприклад, open-source E5 або BGE) теж може працювати локально. LLM — або self-hosted (Llama, Mistral, Qwen), або використовується через Azure OpenAI з EU-регіоном і договором про обробку даних (DPA).
Рекомендація для UA-бізнесу з чутливими клієнтськими даними:
Мінімальний безпечний варіант — векторна база і embedding-модель self-hosted (ваш сервер або приватний VPS), LLM через API з активним DPA і EU-регіоном. Такий варіант не вимагає дорогого GPU-обладнання і задовольняє більшість вимог до захисту персональних даних.
Для компаній у регульованих галузях (фінанси, медицина, юриспруденція) або при наявності клієнтів з ЄС — повний self-hosted стек з open-source LLM є правильним рішенням. Це дорожче і складніше в обслуговуванні, але дані не виходять за межі вашої інфраструктури.
Що потрапляє до LLM-провайдера, а що залишається у вас
При типовій cloud RAG архітектурі розподіл такий:
Залишається у вас: – Оригінальні документи (PDF-договори, файли КП) – Векторна база (якщо self-hosted) – Повна CRM-база з усіма полями
Передається до LLM-провайдера (при API-запиті): – Фрагменти тексту з документів (зазвичай 3–5 абзаців, не повний документ) – Запит менеджера – Системна інструкція
Тобто до LLM-провайдера потрапляє не вся база, а тільки ті фрагменти, що релевантні конкретному запиту. Але якщо ці фрагменти містять персональні дані клієнтів — формально це є обробка персональних даних через третього оператора, що вимагає відповідних договірних відносин згідно з Законом України «Про захист персональних даних» і GDPR, якщо ваші клієнти з ЄС.
Скільки коштує і скільки часу займає: реалістичний кошторис
Ціни на ринку для UA-бізнесу суттєво відрізняються від міжнародних орієнтирів. Наприклад, американський ринок називає $35K–$80K за «пілот» RAG-інтеграції — це нерелевантно для компанії з 30–100 менеджерами в Україні.
Пілот на одному джерелі даних (2–4 тижні)
Що входить: підключення одного типу даних (наприклад, тільки PDF-договори з CRM або тільки нотатки менеджерів) до RAG-пайплайну. Telegram-бот або простий веб-чат як інтерфейс. Налаштування синхронізації (ручна або автоматична раз на день).
Для кого: компанія 20–100 осіб, хоче перевірити концепцію на реальних даних перед повним впровадженням.
Орієнтовний бюджет: 40 000 — 80 000 грн, залежно від обсягу документів і рівня кастомізації.
Результат: через 2–4 тижні у вас є працюючий прототип на реальних даних, і ви бачите, чи вирішує він вашу задачу до інвестицій у повну інтеграцію.
Повна інтеграція з CRM (6–12 тижнів)
Що входить: підключення всіх трьох шарів даних (структуровані поля, нотатки, вкладені файли), автоматична синхронізація за розкладом, confidence threshold і anti-hallucination механізми, розмежування доступу (менеджер бачить тільки своїх клієнтів), налаштування інтерфейсу (Telegram-бот, вбудований чат, або API для розробників).
Для кого: компанія 50–200 осіб з великою базою клієнтів і накопиченою документацією.
Орієнтовний бюджет: 120 000 — 350 000 грн, залежно від складності CRM, обсягу документів і вимог до безпеки.
Що впливає на ціну вгору: self-hosted інфраструктура (потрібен сервер з GPU), великий обсяг PDF-договорів з низькою якістю (потрібен OCR-пайплайн), складне розмежування прав доступу між відділами.
ROI-орієнтир. Якщо у вашому відділі 10 менеджерів і кожен витрачає в середньому 1.5 години на день на пошук по базі — це 15 годин/день або 330 годин/місяць. При середній вартості робочого часу 200–250 грн/год — 66 000–82 000 грн/місяць прихованих втрат. RAG-інтеграція, яка скорочує цей час на 60–70%, окупається за 2–3 місяці після впровадження.
Для обговорення конкретного бюджету під вашу ситуацію — дивіться послугу автоматизації відділу продажів.
Часті питання
Чи може RAG отримати доступ до всіх клієнтів у базі, або тільки до тих, з ким я особисто працював?
Це залежить від налаштувань розмежування доступу. RAG-система може бути налаштована так само, як і права в самій CRM: менеджер бачить тільки своїх клієнтів, керівник відділу — всіх у своєму відділі, директор — всю базу. Реалізується через фільтрацію metadata при vector search — кожен документ в індексі має мітку «власник» або «відділ», і пошук виконується тільки по відповідних мітках.
Скільки часу займає підготовка бази перед запуском RAG?
Для типової бази 500–2000 клієнтів з накопиченими договорами і листуванням — 1–2 тижні на початкову індексацію. Якщо документи вже в цифровому форматі (текстові PDF, не скани), процес швидший. Скановані PDF або документи низької якості потребують попередньої OCR-обробки — ще 1–3 тижні залежно від обсягу.
RAG відповідатиме тільки на запити по конкретному клієнту, або можна питати «по всій базі»?
Обидва варіанти можливі. «Яка знижка у клієнта X» — запит по конкретному клієнту. «Які клієнти мають умову відтермінування 30+ днів» — запит по всій базі. Другий тип запитів у RAG менш надійний, ніж у Text-to-SQL: RAG добре знаходить конкретні фрагменти, але може пропустити деяких клієнтів при масовому пошуку. Для аналітичних запитів по всій базі краще Text-to-SQL.
Якою мовою можна ставити питання AI-асистенту?
Сучасні LLM (GPT-4o, Claude 3.5, Gemini 1.5) добре розуміють запити українською і змішані запити (укр + англ + рус). Але якщо документи у вашій базі переважно одніє мовою, а питання — іншою, якість retrieval може знизитись. Рекомендуємо, щоб мова запитів і мова документів збігались або система мала вбудований переклад.
Що відбудеться, якщо менеджер звільниться і до його бази RAG-асистент дасть неповну картину?
RAG індексує дані, не рахуючи, хто їх додав. Якщо звільнений менеджер залишив нотатки і договори в CRM — вони залишаються в індексі і доступні наступному відповідальному (відповідно до прав доступу в CRM). Це одна з переваг RAG: знання не зникають разом зі звільненим менеджером.
Чи треба переіндексовувати всю базу при оновленні документів?
Ні. При правильній архітектурі синхронізація інкрементальна: нові і оновлені документи додаються до індексу, видалені — видаляються. Повне переіндексування потрібне тільки при зміні embedding-моделі або радикальній реструктуризації даних — і це планова операція, не щоденна.
Чи можна спершу підключити тільки PDF-договори, а потім додати нотатки і email?
Так, і це рекомендований підхід. Починати з одного джерела даних — менше ризиків, швидше запуск, простіше оцінити результат. Потім за 2–4 тижні підключається наступний шар. Поетапне впровадження дозволяє команді звикнути до нового інструменту і виявити проблеми на малому масштабі.
Що робити далі: з чого почати
RAG-інтеграція з CRM — не разовий проект, а процес у три кроки.
Крок 1: AI-аудит (безкоштовно або 15 000 грн). Ми аналізуємо стан ваших даних у CRM: обсяг і якість PDF-вкладень, наявність і структуру нотаток, тип і архітектуру вашої CRM-системи. На виході — конкретна рекомендація: чи готова база до RAG, який шар підключати першим, який стек оптимальний для вашого випадку.
Крок 2: Пілот на одному джерелі (2–4 тижні, 40–80 тис. грн). Беремо найбільш болючу точку — наприклад, пошук по PDF-договорах або по нотатках менеджерів — і робимо робочий прототип. Ви бачите на своїх реальних даних, чи вирішує це вашу задачу.
Крок 3: Повна інтеграція (6–12 тижнів). Якщо пілот показав результат — масштабуємо на всі шари даних, налаштовуємо права доступу, автоматизуємо синхронізацію, підключаємо до зручного інтерфейсу для команди.
Детальніше про те, як виглядає впровадження корпоративного AI-асистента на базі RAG — в статті про корпоративний AI-асистент на RAG.
Якщо хочете обговорити, чи підходить RAG для вашої CRM і якого ефекту реально очікувати — зв’яжіться з нами для безкоштовної консультації. Розкажіть, яка CRM, скільки клієнтів у базі і де зараз найбільший «провал» у пошуку — і ми скажемо чесно, чи є сенс рухатись далі.