Два місяці тому ви запустили AI-пілот. Команда витратила кілька тижнів на налаштування, підрядник виставив рахунок, і тепер система «начебто працює». Але що насправді відбулось? Чи варто вкладати ще — чи краще зупинитись?
Якщо у вас немає чіткої відповіді — ви не одинокі. За оцінками аналітиків, близько 80–90% AI-пілотів не дають вимірюваного фінансового результату. Причина рідко буває технічною. Найчастіше — пілот запускали без заздалегідь погоджених критеріїв оцінки. Без них навіть успішне впровадження виглядає як «незрозумілий результат».
Ця стаття — практичний фреймворк для власника або операційного директора компанії на 20–200 осіб. Не теорія про «digital transformation» і не загальні слова про «вимірювання ефективності». Конкретні рівні метрик, пороги ухвалення рішень і таблиця scoreboard, яку можна роздрукувати й покласти на стіл перед підсумковою зустріччю з командою.
Якщо ви ще тільки плануєте запустити автоматизацію — спочатку прочитайте з чого почати автоматизацію бізнесу, а потім повертайтесь сюди.
Чому більшість AI-пілотів не вміють оцінювати самі себе
Пілот без «умов зупинки» — це не пілот, а демо
Класичний сценарій: компанія домовляється з підрядником, запускає AI-інструмент на одному відділі, проходить 4–8 тижнів — і починається обговорення «що далі». Але ніхто заздалегідь не домовився, що саме буде свідчити про успіх. Менеджер відділу задоволений, бо «стало зручніше». Підрядник задоволений, бо «система працює». Власник не задоволений, бо грошей більше не стало — але і менше теж.
Справжній пілот — це контрольований експеримент з чіткими умовами підтвердження або спростування гіпотези. Без цих умов пілот перетворюється на безстрокове демо, за яке ви продовжуєте платити.
Перш ніж запускати будь-який AI-пілот, потрібно домовитись про три речі: – Що вимірюємо — конкретні метрики, а не «ефективність». – Які пороги вважати успіхом — наприклад, «час обробки замовлення скорочується мінімум на 30%». – Скільки часу даємо — конкретна дата review, після якої приймається рішення.
Різниця між «AI працює» і «AI приносить гроші»
Технічний успіх і бізнес-результат — це не одне й те саме. Модель може правильно класифікувати 95% звернень клієнтів — і при цьому не скорочувати кількість операторів підтримки, бо команда не перебудувала свої процеси під нові можливості.
Запитайте себе: пілот відповів на питання «чи може AI виконати цю функцію?» — або на питання «чи стало нам вигідніше після того, як AI виконує цю функцію?». Власнику потрібна відповідь на друге питання. Підрядникові зазвичай достатньо першого.
Саме тому оцінка пілоту починається не після його завершення, а ще на етапі підготовки: з визначення baseline (вихідного стану) і з прив’язки метрик до реальних бізнес-наслідків.
Три рівні метрик, які треба відстежувати
Більшість компаній або зупиняються на технічних метриках («модель відповідає правильно у 92% випадків»), або одразу намагаються побачити зміни у виручці — і не бачать, бо між технічним успіхом і фінансовим результатом є проміжний рівень.
Щоб оцінка була повною, потрібно відстежувати три рівні одночасно.
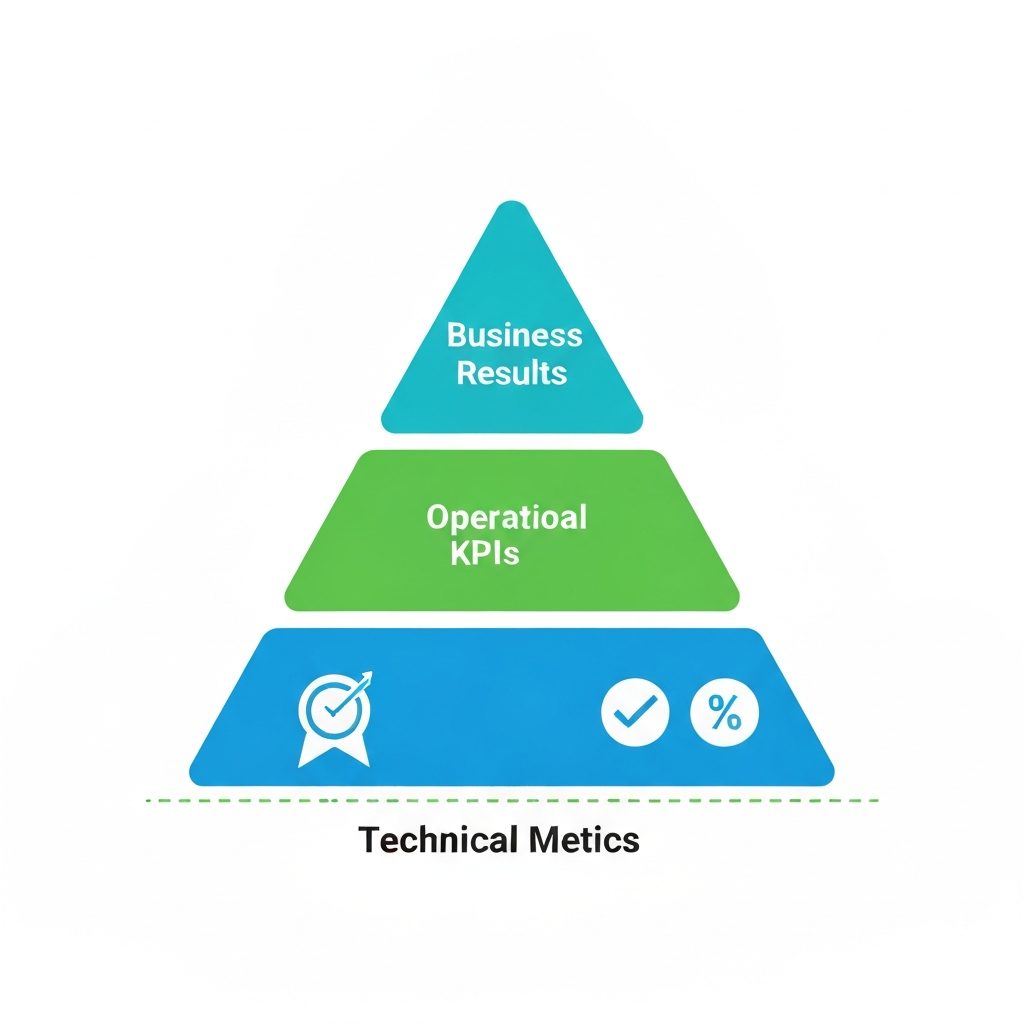
Рівень 1 — технічні метрики моделі (accuracy, latency, failure rate)
Цей рівень відповідає на питання: «Чи коректно AI виконує свою функцію?»
Основні технічні метрики: – Accuracy (точність) — частка правильних відповідей або дій від загальної кількості. Наприклад, для класифікатора звернень: скільки звернень правильно визначено як «скарга», «питання про оплату», «технічна проблема». – Latency (затримка) — час від запиту до відповіді. Для чат-боту підтримки — критична метрика: якщо відповідь займає 8 секунд, клієнт закриває вікно. – Failure rate (частота помилок) — скільки разів система відмовляє або повертає некоректну відповідь. Навіть при accuracy 95%, якщо failure rate 2% на критичних операціях — це 1 з 50 транзакцій з помилкою. – Hallucination rate — специфічна метрика для генеративних моделей: як часто AI генерує впевнену, але хибну відповідь.
Технічні метрики — необхідна умова, але недостатня. Якщо тут є проблеми — пілот треба зупинити ще на першому рівні. Якщо все добре — переходимо до другого.
Рівень 2 — операційні KPI процесу (час обробки, кількість помилок, % ручних виправлень)
Цей рівень відповідає на питання: «Чи змінилась ефективність процесу?»
Метрики другого рівня вимірюють, як AI вплинув на конкретний робочий процес, а не на якість моделі абстрактно: – Середній час обробки одиниці — документа, замовлення, звернення. – % ручних виправлень — скільки виходів AI команда виправляє вручну. Якщо менеджер витрачає більше часу на виправлення AI, ніж займало б ручне виконання — це сигнал другого рівня. – Adoption rate (рівень використання) — скільки % команди реально користуються інструментом. Детально про нього — у розділі про Scoreboard. – Кількість помилок у процесі — наприклад, скільки замовлень оброблено з помилкою до vs. після AI.
Автоматизація бізнес-процесів — це не просто «встановити інструмент», а перебудова роботи команди навколо нього. Якщо adoption rate низький, операційні метрики не покращуються навіть при технічно гарній моделі.
Рівень 3 — бізнес-результат (cost per operation, revenue impact, churn, conversion)
Цей рівень відповідає на питання: «Чи вплинув AI на фінансовий результат?»
- Cost per operation — скільки коштує обробка одиниці (звернення, замовлення, документа) до і після AI. Для компанії з 50 співробітниками навіть 15% зниження cost per operation у ключовому процесі — це реальні гроші.
- Revenue impact — чи збільшилась виручка внаслідок AI? Це складніше виміряти прямо, але можна через conversion rate, середній чек, швидкість угоди.
- Churn (відтік клієнтів) — якщо AI впроваджувався у підтримку, зміна churn rate є прямим індикатором якості клієнтського досвіду.
- Time saved × FTE cost — найпростіший спосіб порахувати ROI: скільки годин на місяць звільнено × вартість однієї години відповідного спеціаліста.
Таблиця 1. Три рівні метрик — приклади і «зелені» пороги
| Рівень | Метрика | Приклад | «Зелений» поріг |
|---|---|---|---|
| 1 — Технічний | Accuracy | Правильна класифікація звернень | > 90% |
| 1 — Технічний | Latency | Час відповіді чат-боту | < 3 сек |
| 1 — Технічний | Failure rate | Частка помилкових виходів | < 2% |
| 2 — Операційний | Середній час обробки | Хвилини на документ/замовлення | Скорочення > 25% |
| 2 — Операційний | % ручних виправлень | Частка виходів, які виправляє команда | < 20% |
| 2 — Операційний | Adoption rate | % команди, що реально використовує | > 60% |
| 3 — Бізнес | Cost per operation | Витрата на одиницю процесу | Зниження > 15% |
| 3 — Бізнес | ROI (6-місячний) | (Економія − Витрати) / Витрати | > 50% |
| 3 — Бізнес | Revenue impact | Зміна conversion або виручки | Позитивна зміна |
Для докладнішого розрахунку ROI по вашому процесу — читайте статтю як рахувати ROI від AI.
Як визначити baseline — до запуску пілоту
Без baseline немає оцінки — лише відчуття
Baseline — це «точка відліку»: зафіксований стан процесу до того, як AI почав на нього впливати. Без baseline ви не можете відповісти на питання «стало краще на скільки відсотків», ви можете лише сказати «здається, стало краще».
Власники бізнесу часто пропускають цей крок, бо він здається очевидним або другорядним. Насправді відсутність baseline — це одна з трьох головних причин, чому оцінка пілоту стає суперечливою: підрядник каже «все добре», ви відчуваєте, що «щось не так», але довести ні одне, ні інше неможливо.
Правило: baseline фіксується до запуску пілоту, не після. Якщо пілот вже запустили без baseline — зупиніть автоматизацію на тиждень і виміряйте базовий стан вручну. Це краще, ніж не мати жодних даних.
Що виміряти за тиждень до старту (5 ключових точок)
Виберіть процес, який автоматизується, і за 5–7 робочих днів до запуску AI зафіксуйте:
- Час обробки однієї одиниці — хвилини або години на документ, замовлення, звернення. Виміряйте не «середнє відчуття», а реальні дані: попросіть команду два-три дні записувати час.
- Кількість одиниць за день / тиждень — загальний обсяг процесу. Потрібно для розрахунку загальної економії, а не тільки на одиницю.
- Частота помилок — скільки разів за тиждень виникала потреба в повторній обробці, поверненні документа, уточненні у клієнта.
- Кількість FTE (повних ставок), залучених до процесу — скільки людей і який % їхнього часу займає цей процес.
- Вартість однієї обробки — якщо можна порахувати: FTE hours × годинна ставка + прямі витрати.
Де брати дані, якщо процес «не оцифрований»
Типовий сценарій для українського SMB: процес існує, але у «голові менеджера» або в Excel-табличці без часових позначок. У цьому разі:
- CRM-система — якщо є KeyCRM, NetHunt або інші, завантажте виписку за останні 4–6 тижнів. Дата створення і дата закриття угоди / звернення — це вже час обробки.
- Google Таблиці / Excel — попросіть менеджера вести журнал протягом одного тижня: час початку, час завершення, чи були помилки. Навіть один тиждень дає достатній baseline для пілоту.
- Усний облік — якщо немає нічого, проведіть структуровані інтерв’ю з 2–3 людьми, що ведуть процес. «Скільки часу займає обробка одного замовлення?», «Скільки помилок на тиждень?» — відповіді запишіть як «оцінку команди». Це не ідеально, але краще ніж нічого.
Чеклист baseline: 5 запитань перед стартом пілоту
- [ ] Ми знаємо, скільки хвилин займає одна операція зараз?
- [ ] Ми знаємо, скільки таких операцій за тиждень?
- [ ] Ми знаємо, як часто виникають помилки або повторна обробка?
- [ ] Ми знаємо, скільки людей і який % їх часу займає цей процес?
- [ ] Ми домовились, яке покращення вважатимемо успіхом пілоту?
Scoreboard — таблиця прийняття рішень для власника
Це центральний інструмент статті. Scoreboard — це не звіт для звіту. Це таблиця, яку ви заповнюєте після завершення пілоту і кладете перед командою на review-зустріч. Три хвилини перегляду — і рішення очевидне.
Зелено / Жовто / Червоно — поріг для кожного рівня метрик
Логіка проста: зелений — масштабуємо, жовтий — доопрацьовуємо і перезапускаємо, червоний — зупиняємось і аналізуємо причину.
Пороги нижче — орієнтовні бенчмарки для компаній 20–200 осіб. Для вашого конкретного процесу вони можуть відрізнятись, але відхилення від цих орієнтирів потребує обґрунтування.
Скільки часу давати пілоту
Тривалість пілоту залежить від типу процесу:
| Тип процесу | Рекомендований термін пілоту | Чому |
|---|---|---|
| Чат-бот підтримки | 4–6 тижнів | Швидкий цикл взаємодії, дані накопичуються швидко |
| Кваліфікація лідів | 6–8 тижнів | Потрібно достатньо угод для статистичної значущості |
| Обробка документів / замовлень | 4–6 тижнів | Залежить від обсягу — мінімум 200–300 одиниць |
| HR / рекрутинг | 8–12 тижнів | Тривалий цикл, мало позицій за короткий час |
| Генерація контенту | 3–4 тижні | Швидкий результат, видно одразу |
Не давайте пілоту «ще один місяць», якщо після першого review-чекпоінту (половина терміну) метрики червоні. Затягування пілоту без зміни підходу — це найдорожча помилка. Або виправляйте причину, або зупиняйтесь.
Adoption rate як головна попереджувальна метрика
Adoption rate — це відсоток команди, яка реально користується AI-інструментом від тих, хто мав би ним користуватись. Якщо 10 менеджерів мають працювати з новою системою, але реально використовують її 4 — adoption rate = 40%.
Саме adoption rate є найраннішим індикатором проблеми. Він падає нижче норми ще до того, як операційні метрики стають червоними. Причини низького adoption rate: – Інструмент незручний або вимагає зайвих кроків. – Команду не навчили або навчили формально. – Немає «власника процесу», який підтримує впровадження. – Люди не розуміють, навіщо це їм особисто.
Якщо через 4 тижні adoption rate < 40% — це вже не «жовтий», а сигнал для зупинки або повної переробки підходу.
Таблиця Scoreboard — повна версія
Scoreboard: оцінка AI-пілоту
| # | Метрика | Що вимірюємо | Зелено (масштабуємо) | Жовто (доопрацьовуємо) | Червоно (зупиняємось) | Ваш результат |
|---|---|---|---|---|---|---|
| ТЕХНІЧНИЙ РІВЕНЬ | ||||||
| 1 | Accuracy моделі | % правильних відповідей / класифікацій | > 90% | 75–90% | < 75% | |
| 2 | Latency | Середній час відповіді / обробки | < 3 сек | 3–8 сек | > 8 сек | |
| 3 | Failure rate | % відмов або некоректних виходів | < 2% | 2–5% | > 5% | |
| 4 | Uptime | % часу доступності системи | > 99% | 95–99% | < 95% | |
| ОПЕРАЦІЙНИЙ РІВЕНЬ | ||||||
| 5 | Adoption rate | % команди, що реально використовує | > 60% | 40–60% | < 40% | |
| 6 | Час обробки одиниці | Хв. / год. на документ, замовлення, звернення | Скорочення > 30% | Скорочення 10–30% | Скорочення < 10% або зростання | |
| 7 | % ручних виправлень | Частка виходів AI, які команда редагує | < 15% | 15–35% | > 35% | |
| 8 | Кількість помилок процесу | Помилки, повернення, уточнення | Зниження > 30% | Зниження 10–30% | Без змін або зростання | |
| 9 | Навантаження на команду | Суб’єктивна оцінка зручності (1–5) | 4–5 | 3 | 1–2 | |
| БІЗНЕС-РІВЕНЬ | ||||||
| 10 | Cost per operation | Витрата на одиницю процесу | Зниження > 20% | Зниження 5–20% | Зниження < 5% або зростання | |
| 11 | ROI прогнозний (12 міс.) | (Річна економія − Витрати) / Витрати | > 100% | 30–100% | < 30% | |
| 12 | Вплив на клієнтський досвід | CSAT, NPS або кількість скарг | Покращення > 10% | Без змін | Погіршення | |
| 13 | Час до першого результату | Тижні від старту до перших позитивних метрик | < 3 тижнів | 3–6 тижнів | > 6 тижнів |
Як читати Scoreboard: – 3+ зелених на кожному рівні + жоден критичний (accuracy, adoption rate, cost) не червоний → масштабуємо. – Є жовті, немає червоних критичних → доопрацьовуємо і перезапускаємо. – Будь-який критичний показник (accuracy < 75%, adoption rate < 40%, cost зростає) → зупиняємось і аналізуємо.
Конкретні KPI по типах процесів
Загальні метрики — хороший фундамент, але кожен тип процесу має свої специфічні сигнали. Ось практичні KPI для найпоширеніших сценаріїв AI-впровадження в SMB.
Customer support / чат-бот підтримки
Це найчастіший перший пілот для компаній 30–100 осіб. Детальніше про AI-підтримку клієнтів — на сторінці послуги AI-чатботів.
Ключові KPI: – First Contact Resolution Rate (FCR) — частка звернень, вирішених без ескалації до живого оператора. Цільовий поріг: > 65% для стандартних запитів. – Escalation rate — скільки % звернень AI передає живому оператору. Якщо > 50% — AI не справляється з реальним потоком. – CSAT (Customer Satisfaction Score) — оцінка задоволеності клієнта після взаємодії. Вимірюється коротким опитуванням (1–2 питання в кінці сесії). Мінімальний прийнятний рівень: 3.8/5. – Average Handle Time (AHT) — середній час взаємодії. AI-чат має обробляти типове звернення менш ніж за 3 хвилини, тоді як оператор витрачає 7–12 хвилин. – Повторні звернення — якщо клієнт повертається з тим самим питанням протягом 48 годин, FCR штучно завищений.
Продажі / кваліфікація лідів
- Lead conversion rate — % лідів, що перейшли від першого контакту до кваліфікованої угоди. Якщо AI-кваліфікація знизила conversion rate — щось не так із налаштуванням.
- Time-to-qualify — скільки часу займає кваліфікація одного ліда. Бенчмарк для ручного процесу в українських компаніях: 25–45 хвилин. Після AI: < 10 хвилин на стандартний лід.
- % ручного втручання — скільки угод після AI-кваліфікації потребували ручного перегляду. Якщо > 40% — менеджери не довіряють системі або вона дає хибні спрацьовування.
- Вартість кваліфікованого ліда — CAC-складова. Якщо AI-кваліфікація не знижує цю цифру протягом 8 тижнів, ROI-підстав для масштабування немає.
Детальніше про автоматизацію продажів — на сторінці послуги.
Документи / обробка замовлень
Один із найбільш «вимірюваних» процесів — цифри тут прямі.
- Час обробки одного документа — від отримання до готового результату. Типовий бенчмарк для ручної обробки в SMB: 15–40 хвилин. Після AI: 2–8 хвилин.
- % документів з помилками — кількість документів, що потребують повернення або виправлення. Мета: < 5% після впровадження проти > 10–15% при ручній обробці.
- Вартість операції — (FTE час × ставка + overhead) / кількість документів. Навіть скорочення на 20% при обсязі 500 документів/місяць — суттєва економія.
- SLA compliance — % документів, оброблених у встановлений термін. Якщо клієнти або партнери мають SLA-вимоги, цей KPI критичний.
HR / рекрутинг
Процес довший, тому і тривалість пілоту більша — 8–12 тижнів.
- Time-to-hire — від відкриття вакансії до підписання офферу. Середній показник по ринку: 25–40 днів. Якщо AI-скринінг не скорочує його мінімум на 30% — впровадження не виправдане.
- % автоматично відхилених нерелевантних CV — скільки резюме AI відсіяв без участі рекрутера. Якщо цифра < 50% — AI не розвантажує команду.
- Якість найму — процент кандидатів, що пройшли випробувальний термін, серед тих, яких запропонував AI. Якщо AI пропускає кандидатів, які потім не приживаються, — точність скринінгу треба переглянути.
- Час рекрутера на скринінг — годин на тиждень. Це найпростіший операційний KPI: якщо рекрутер не відчув полегшення — щось не налаштовано.
Рішення «масштабуємо або зупиняємось» — покрокова процедура
Хто приймає рішення
Рішення про масштабування або зупинку приймає власник бізнес-процесу — керівник відділу або операційний директор — разом з власником компанії. Не IT-команда, не підрядник.
Підрядник може мати упередженість: йому вигідно масштабування. IT-менеджер може захищати технічне рішення, до якого прив’язаний. Бізнес-власник процесу дивиться на інше: чи стало операційно легше, чи команда задоволена, чи клієнти відчули різницю.
Якщо у вашій компанії немає окремого IT-відділу (типово для 20–80 осіб) — це нормально. Рішення все одно приймає той, чий процес автоматизувався.
Формат review-зустрічі після пілоту (agenda на 60 хвилин)
Структурована зустріч після завершення пілоту — не бюрократія, а спосіб отримати рішення за одну годину замість двох тижнів листування.
Agenda review-зустрічі (60 хвилин):
| Час | Блок | Відповідальний |
|---|---|---|
| 0–10 хв | Нагадування про початкову гіпотезу і погоджені пороги | Власник процесу |
| 10–25 хв | Презентація Scoreboard — зелено/жовто/червоно по кожній метриці | Підрядник або аналітик |
| 25–40 хв | Зворотний зв’язок команди — що зручно, що не зручно, adoption-проблеми | Тімлід відділу |
| 40–50 хв | Прогноз ROI на 12 місяців при масштабуванні | Підрядник |
| 50–60 хв | Рішення та наступні кроки | Власник бізнесу |
Ключове правило: рішення приймається на цій зустрічі, не «після додаткового обдумування». Додаткові тижні без рішення зазвичай означають, що метрики жовті або червоні, і ніхто не хоче першим це визнати.
Три можливі висновки
1. Масштабуємо
Умови: більшість показників Scoreboard зелені, жоден критичний показник не червоний, команда підтримує продовження. Наступний крок: погоджуємо план впровадження на весь відділ або компанію, бюджет і терміни.
2. Доопрацьовуємо і перезапускаємо
Умови: є жовті показники, нема критично червоних, команда розуміє причину проблем. Наступний крок: підрядник отримує конкретний список змін з термінами, після яких запускається новий пілот на 3–4 тижні. Важливо: перезапуск — не продовження. Це новий відлік із оновленими гіпотезами.
3. Зупиняємось з висновком
Умови: критичні показники червоні, або проблема не у налаштуваннях, а у самій гіпотезі. Наступний крок — розбір причин і документування висновку. Це не поразка, це результат пілоту.
Як «зупинитись правильно»
Зупинка пілоту — нормальний і корисний результат. Бути зупинитись неправильно означає двояко: або «ми більше ніколи не спробуємо AI» (хибний висновок), або «тихо заховаємо результат, щоб нікому не соромно» (втрачений досвід).
Правильна зупинка виглядає так: – Фіксуємо висновок письмово: що перевіряли, що отримали, чому зупинились. – Відповідаємо на питання: «Яка гіпотеза провалилась — технічна чи бізнесова?» Якщо технічна — можна спробувати інший інструмент. Якщо бізнесова («цей процес не дозволяє автоматизуватись без структурної перебудови») — фіксуємо і шукаємо інший процес. – Зберігаємо baseline і дані пілоту — вони знадобляться при наступному пілоті. – Інформуємо команду чесно: «Ми спробували, результату не отримали, ось чому, ось що далі». Команда, яка бачить що компанія вміє зупинятись і пояснювати рішення — більше довіряє наступним спробам.
Помилки, які спотворюють оцінку пілоту
Рахуємо економію від пілоту, а не від повного впровадження
Пілот за визначенням — обмежений. Ви тестуєте на 10% процесу, 20% команди або одному регіоні. Якщо у пілоті задіяно 3 менеджери з 15, а економія на 3 менеджерах склала 40 годин/місяць — не проектуйте це на «ми заощадимо 200 годин при повному впровадженні». Масштабний ефект рідко є лінійним: є витрати на навчання, є технічні ускладнення при масштабуванні, є нові крайні випадки, яких у пілоті не було.
Правильний підхід: прогноз для масштабування будуйте консервативно — беріть 60–70% від пілотного результату.
Ігноруємо adoption rate — «технічно працює, але люди не користуються»
Це найбільш поширена помилка. Підрядник показує технічні метрики: «система відповідає правильно у 94% випадків». Але якщо лише 3 з 10 менеджерів реально відкривають систему щодня — операційного ефекту немає. Технічна якість моделі при низькому adoption rate — це дорога іграшка, яку показують на дермо.
Adoption rate < 40% через 6 тижнів — це автоматично жовтий або червоний показник, незалежно від стану інших метрик.
Порівнюємо з нереалістичним baseline
Якщо ви читали кейси Genesis або EPAM про впровадження AI і очікуєте подібних результатів — це хибна точка відліку. Для компанії на 50 осіб без IT-відділу і з нестандартизованими процесами скорочення часу обробки на 30–40% — це відмінний результат. Порівняння з кейсами enterprise-рівня формує хибне відчуття «наш пілот не вдався», тоді як насправді він дав хорошу віддачу.
Єдиний правильний baseline — це ваш власний процес, виміряний до пілоту.
Як виглядає оцінка пілоту в нашій практиці
Анонімізований приклад: виробнича компанія, ~70 осіб, Західна Україна. Процес — обробка вхідних замовлень від дилерів. До пілоту: менеджер вручну переносив дані з email і PDF у CRM, середній час — 22 хвилини на замовлення, 80–120 замовлень на тиждень, 2–3 помилки на тиждень через ручне введення.
Запустили пілот: AI-агент читає вхідні листи і PDF, структурує дані, заносить у CRM через API. Термін пілоту — 5 тижнів.
Що виміряли: – Час обробки одного замовлення: 22 хв → 4 хв. Скорочення 82%. Зелено. – Adoption rate: 5 з 6 менеджерів використовують стабільно з 3-го тижня. Зелено. – % помилок: 2.5/тиждень → 0.3/тиждень. Зелено. – Failure rate: 3.8% — AI не міг правильно розпізнати нестандартні PDF від 2 дилерів. Жовто. – Cost per order: зниження на 27%. Зелено.
Рішення на review-зустрічі: масштабуємо, паралельно вирішуємо проблему з нестандартними форматами двох дилерів (підрядник отримав конкретне ТЗ на 2 тижні).
Якщо хочете зрозуміти, чи вдався ваш пілот, або плануєте стартувати і потрібна допомога з визначенням метрик і baseline — замовте безкоштовний AI-аудит за 5 днів. Ми аналізуємо процес, пропонуємо гіпотезу і пілот з фіксованим бюджетом і погодженими KPI ще до старту.
Часті питання
Скільки часу займає оцінка AI-пілоту?
Сам процес оцінки — review-зустріч і аналіз Scoreboard — займає 1–2 дні, якщо дані збирались протягом пілоту. Якщо baseline не фіксувався, доведеться витратити ще 3–5 днів на збір ретроспективних даних або коротке вимірювання поточного стану. Загальна рекомендація: закладайте на оцінку тиждень після завершення активної фази пілоту.
Які метрики найважливіші для малого бізнесу?
Для компанії на 20–80 осіб найважливіші три: adoption rate (чи використовує команда), час обробки одиниці (чи прискорився процес) і cost per operation або «звільнений час × ставка» (чи є економічний сенс). Технічні метрики важливі, але без перших двох операційних вони не мають практичного значення для бізнесу.
Що робити, якщо дані для baseline не збирались?
Зупиніть автоматизацію на 5–7 робочих днів і виміряйте вручну. Якщо зупинка неможлива — проведіть структуровані інтерв’ю з командою («скільки часу займає задача?», «скільки помилок на тиждень?») і зафіксуйте їхні оцінки як baseline. Це не ідеальна точність, але краще за відсутність будь-якого відліку. Позначайте такі дані як «оцінка команди», а не точні цифри.
Як відрізнити «пілот провалився» від «пілот потребує доопрацювання»?
Якщо технічні метрики (accuracy, failure rate) зелені або жовті, але операційні або бізнес-метрики червоні — найчастіше причина в adoption або неправильному впровадженні, а не у самій технології. Це «жовтий сигнал» — доопрацювання. Якщо навіть технічні метрики червоні (accuracy < 75%, failure rate > 5%) — це провал гіпотези про застосовність даної технології до даного процесу. Тут треба або міняти підхід принципово, або зупинятись.
Чи потрібен окремий аналітик для оцінки пілоту?
Для компаній до 100 осіб — ні. Scoreboard-таблицю заповнює менеджер процесу або операційний директор за даними з CRM, таймшитів і системи підрядника. Якщо підрядник не може надати базові метрики (accuracy, latency, failure rate) — це вже червоний сигнал сам по собі: нормальний підрядник веде ці дані в реальному часі.
Що означає adoption rate і як його виміряти?
Adoption rate — відсоток людей з цільової групи, що реально використовують AI-інструмент у своїй роботі. «Реально використовують» — це не «мають доступ», а «виконали мінімум X дій за тиждень». Як виміряти: запитайте в підрядника лог активності (кількість унікальних користувачів за тиждень / загальна кількість людей у цільовій групі). Якщо підрядник не може надати цю цифру — попросіть доступ до адмін-панелі або виміряйте опитуванням команди.
Висновок
Оцінка AI-пілоту — це не технічний звіт. Це рішення про інвестицію: чи вкладати далі, і якщо так — то що саме фінансувати.
Три практичних кроки, які варто зробити прямо зараз:
Перший — якщо пілот ще не запущено, погодьте Scoreboard-пороги з підрядником до старту. Зафіксуйте baseline. Встановіть дату review.
Другий — якщо пілот вже йде або завершений, заповніть Scoreboard-таблицю з цієї статті. Навіть якщо даних не вистачає — відсутність даних сама по собі є жовтим сигналом.
Третій — якщо Scoreboard дає суперечливу картину або ви не впевнені, яку метрику вважати критичною для вашого процесу, — запишіться на безкоштовний AI-аудит. За 5 днів ми аналізуємо ваш процес, визначаємо правильні KPI і пропонуємо пілот з погодженими умовами успіху ще до першої витраченої гривні.