Якщо ваша компанія веде внутрішні регламенти українською, а технічна документація від вендорів надходить англійською — ви вже стикнулися з проблемою, яку більшість туторіалів з RAG ігнорують. Базову архітектуру RAG (витягання (retrieval) + генерація) описано в окремій статті серії — RAG-архітектура для бізнесу. Тут ми відразу переходимо до практичного питання: що відбувається, коли у вашій базі знань співіснують дві мови, і як змусити систему працювати коректно в обох.
За даними практиків, які будують RAG для підприємств, 40% часу розробки йде саме на роботу з метаданими та структурою документів — і це дає найвищий ROI з усіх технічних рішень. Помилка з мовним складом корпусу коштує дорожче, ніж вибір «неправильної» embedding-моделі. Розберемо чому — і що з цим робити.
Чому мова документів — проблема, яку недооцінюють
Типова картина: технічна документація EN, регламенти UA, Slack — суміш
Відкрийте будь-яку IT-компанію або B2B-бізнес з 50–200 співробітниками в Україні. З великою ймовірністю ви побачите таку картину:
- Notion — внутрішні HR-регламенти, онбординг-гайди, процедури у відділах написані українською. Нові документи після 2022 року майже виключно UA.
- Confluence або SharePoint — технічна документація продукту: API-специфікації, архітектурні рішення, Release Notes. Якщо продукт має міжнародних клієнтів або партнерів — 80–90% цих документів англійською.
- Google Docs / Drive — комерційні пропозиції, шаблони контрактів. Залежно від клієнтської бази — мішанина UA і EN.
- Slack або Teams — хаотичне поєднання мов залежно від треду, учасників і теми.
Коли така компанія вирішує побудувати корпоративного AI-асистента, перше питання зазвичай технічне: «яку модель обрати?». Правильне ж питання: «як система знайде правильний документ, якщо запит і документ — різними мовами?».
Що відбувається коли RAG «не розуміє» мову чанка
Стандартний RAG-pipeline виглядає так: документ ділиться на фрагменти (чанки), кожен фрагмент перетворюється на вектор (числове представлення змісту), запит користувача також перетворюється на вектор, і система знаходить найближчі вектори у базі. Потім LLM формулює відповідь на основі знайдених фрагментів.
Якщо у вас однотипний корпус однією мовою — все працює. Якщо корпус мішаний — виникає кілька типів збоїв:
Семантичний розрив. Модель, натренована переважно на англійському тексті, може «вважати», що речення «Договір підряду необхідно підписати у двох примірниках» і «The contract must be signed in two copies» семантично далекі одне від одного, хоча зміст ідентичний. Запит українською не знайде відповідного EN-документа, хоча він існує.
Шум у ранжуванні. Навіть якщо семантичний пошук знаходить EN-документ за UA-запитом, його рейтинг (score) виявляється нижчим за менш релевантний UA-документ. Система «вибирає» не ту відповідь — не тому що не знайшла правильну, а тому що неправильно її ранжувала.
15–20% failure rate у спеціалізованих доменах — це задокументована реальність enterprise RAG-проектів, а не теоретичний ризик. При масштабі 100 запитів на день — це 15–20 невірних або порожніх відповідей щодня.
Мовний зсув відповіді: коли знайшов правильне, але відповів неточно
Окрема проблема — мовний зсув (language bias) відповіді. LLM знайшов правильний EN-документ, але формулює відповідь українською (що правильно з точки зору інтерфейсу). У процесі «перекладу» технічні терміни втрачають точність.
Приклад: в EN-документі написано «The service operates in eventual consistency mode». LLM перекладає це як «сервіс працює в режимі кінцевої узгодженості» — технічно вірно, але для розробника, який знає термін «eventual consistency», це формулювання менш корисне, ніж якби воно залишилося в оригіналі з коротким поясненням.
Ще гірше, коли терміни перекладаються неоднозначно. «Deployment» може стати «розгортанням» або «впровадженням» — два різних процеси. «Pipeline» стає «конвеєром» або «пайплайном» — різні регістри для різних аудиторій.
Всі ці проблеми вирішуються — але спочатку потрібно зрозуміти, де вони виникають на архітектурному рівні.
Як влаштований мультимовний RAG зсередини
Embedding-простір і чому мова «зникає» при правильній моделі
Вбудовування (embedding) — це числовий вектор, що представляє зміст тексту. Ключова властивість якісної мультимовної embedding-моделі: семантично близькі тексти різними мовами мають близькі вектори, навіть якщо їхній лексичний склад зовсім різний.
Простіше кажучи: якісна модель «знає», що «договір» і «contract» означають приблизно одне й те ж в юридичному контексті — і розмістить їх у схожих точках векторного простору. Запит «яка процедура підписання договору» знайде англійський документ «Contract Signing Procedure» навіть без ключового слова «договір» в ньому.
Але є нюанс: не всі embedding-моделі однаково добре підтримують українську мову. Більшість популярних моделей натренована переважно на англійському тексті з домішком основних європейських мов. Українська, як мова з меншим представленням у тренувальних даних, часто отримує гірші вектори — особливо для доменної лексики.
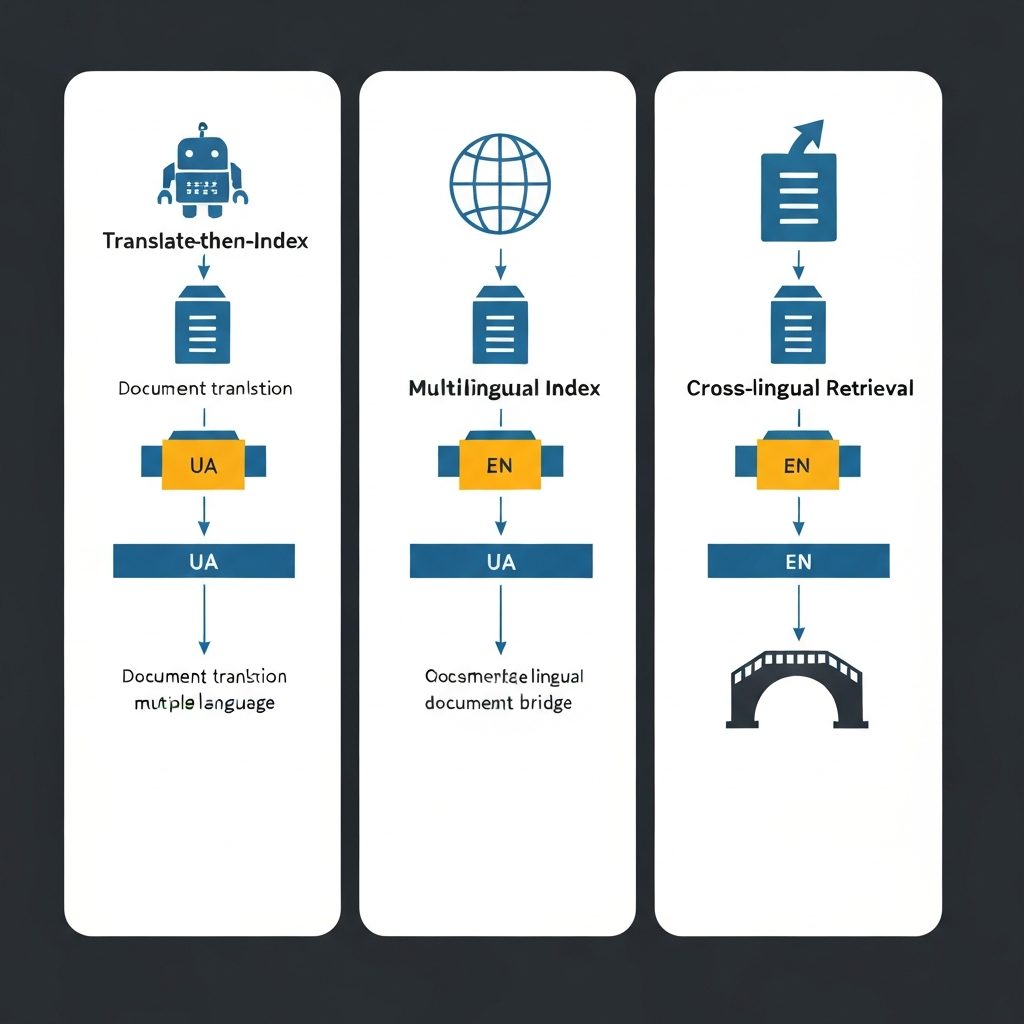
Три архітектурні підходи: translate-then-index, index-multilingual, cross-lingual retrieval
Для мультимовного RAG існує три базових архітектурні підходи, кожен з яких має свої сценарії застосування.
Translate-then-index (переклад перед індексацією). Усі документи перекладаються однією мовою (як правило, англійською) до того, як потрапляють у векторну базу. Запити також перекладаються перед пошуком.
Переваги: простота, передбачуваність, добре працює зі стандартними англомовними embedding-моделями.
Недоліки: витрати на переклад (особливо при великому корпусі), втрата нюансів і термінів при перекладі, необхідність оновлювати переклад при кожному оновленні документа. Для юридичних або технічних текстів — значні ризики похибок.
Index-multilingual (мультимовна індексація). Документи індексуються в оригінальних мовах, але використовується embedding-модель, яка «розуміє» обидві мови і розміщує семантично близькі тексти поруч у векторному просторі, незалежно від мови.
Переваги: немає витрат на переклад, документи зберігають оригінальний текст, одна база для всього корпусу.
Недоліки: якість залежить від підтримки конкретних мов у моделі. Для UA — потрібно уважно перевіряти.
Cross-lingual retrieval (міжмовне витягання). Гібридний підхід: пошук ведеться в кількох мовних просторах одночасно або послідовно, результати об’єднуються з урахуванням мовних вагових коефіцієнтів.
Де кожен підхід ламається і чому hybrid retrieval — обов’язковий
На практиці жоден з трьох підходів не працює ідеально в ізоляції. Ключовий висновок enterprise-практиків: hybrid retrieval — не опція, а вимога. Чистий семантичний пошук у спеціалізованих доменах падає надто часто.
Hybrid retrieval поєднує: – Семантичний пошук (векторне подібність) — знаходить концептуально релевантні фрагменти – Ключове-слівний пошук (BM25 або аналог) — точно знаходить специфічні терміни, назви, коди – Мовні метадані — дозволяють фільтрувати або підвищувати рейтинг документів на конкретній мові
Наприклад: запит «яке значення параметру MAX_RETRY_ATTEMPTS?» — чистий семантичний пошук знайде загальний розділ про налаштування, але не конкретний параметр. Ключове-слівний пошук знайде точно. Hybrid-підхід дає правильний результат.
Вибір embedding-моделі для українського бізнесу
OpenAI text-embedding-3-large — де виграє, де дорого
text-embedding-3-large — одна з найпотужніших комерційних моделей на ринку станом на 2026 рік. Вимірювання на стандартних мультимовних бенчмарках (MIRACL, mMARCO) показують стабільно високі результати, включно з кириличними мовами.
Де виграє: – Проекти, де вже використовується інфраструктура OpenAI – Невеликі корпуси (до 10 000 документів), де вартість API не критична – Змішані технічні тексти EN+UA з сучасною лексикою – Прототипування та MVP — швидкий старт без налаштування
Де дорого або незручно: – Великі корпуси (50 000+ документів) при постійному оновленні — вартість індексації зростає – Регульовані галузі з вимогами data sovereignty — документи надходять на зовнішні сервери OpenAI – On-premise-вимоги — API-залежність унеможливлює повністю ізольований контур
Реальна ціна: при корпусі 20 000 документів по ~500 токенів кожен — індексація коштуватиме близько $4–5 (одноразово). При 1000 запитів на день — приблизно $1,5–2 щодня на embedding-запити. Для більшості компаній 20–200 осіб це прийнятно.
BGE-M3 та інші open-source моделі з підтримкою 100+ мов
BGE-M3 від BAAI (Beijing Academy of Artificial Intelligence) — на сьогодні один з найсильніших відкритих варіантів для мультимовних завдань. Модель підтримує 100+ мов, включно з українською, і при цьому безкоштовна для використання.
Ключові характеристики: – 3 режими retrieval в одній моделі: dense (векторний), sparse (BM25-подібний), multi-vector (ColBERT) – Можливість самостійного розгортання на власній інфраструктурі – Розмір моделі — приблизно 570 MB, що дозволяє запускати навіть без GPU для невеликих корпусів
На практиці для UA-тексту BGE-M3 показує гірші результати, ніж text-embedding-3-large на загальних запитах, але кращі на специфічній технічній термінології — тому що sparse-режим точно знаходить терміни без семантичного «розмиття».
Інші варіанти: – multilingual-e5-large від Microsoft — добре перевірена модель, підтримує 100 мов, трохи поступається BGE-M3 на нових бенчмарках – LaBSE від Google — оптимізована саме для переклад-орієнтованих завдань, 109 мов
Cohere Embed Multilingual — варіант для хмарних рішень
Cohere Embed Multilingual v3.0 — комерційна модель, яка позиціонується як спеціалізована мультимовна альтернатива OpenAI. 100+ мов, включно з українською.
Де Cohere має сенс: – Якщо ви вже використовуєте Cohere Command для генерації — природна інтеграція – Проекти з акцентом на мови, де OpenAI показує слабші результати – Хмарні розгортання з бюджетними обмеженнями (ціна трохи нижча за OpenAI)
Практичне обмеження: Cohere менш поширений серед українських розробників, що означає менше готових рішень і меншу спільноту для підтримки.
Практичний тест: один запит, три моделі, різний результат
Уявімо конкретний сценарій. В базі знань є EN-документ: «The deployment process requires three sequential approvals: technical review by the CTO, security check by InfoSec, and final sign-off by the Project Manager».
Запит українською: «хто підписує технічне рішення перед деплоєм?»
- text-embedding-3-large: знаходить документ з cosine similarity ~0.82 — результат вірний
- BGE-M3 (dense режим): знаходить з similarity ~0.74, але sparse-режим додає бонус за слово «деплой» → hybrid score ~0.79, результат вірний
- multilingual-e5-large: similarity ~0.69, може не потрапити в топ-3 якщо в базі є більш «схожі» за словами, але менш релевантні UA-документи
Це не означає, що e5 погана модель — вона цілком прийнятна для більшості загальних запитів. Але на специфічних технічних запитах різниця відчутна.
Рекомендація для старту: text-embedding-3-large, якщо бюджет дозволяє і немає вимог до on-premise. BGE-M3 з hybrid retrieval — якщо потрібно on-premise або є великий корпус зі специфічною термінологією.
Проблема «мішаного чанка» і як з нею працювати
Що таке мішаний чанк і чому він виникає в корпоративних базах
Мішаний чанк — це фрагмент документа, в якому частина тексту написана однією мовою, частина іншою. Це не теоретична проблема — це повсякденна реальність корпоративних баз.
Як вони виникають:
- Технічна документація з прикладами коду. Основний текст EN, але коментарі в коді залишено UA («// Перевіряємо чи є активна сесія»)
- Регламенти зі вставками з договорів. Основний текст UA, але цитата з міжнародного стандарту EN
- Конфлюенс-сторінки, які редагували різні люди. Перший розділ писала команда UA, другий — додав іноземний партнер EN
- Автоматичний переклад частин. Хтось переклав гугл-перекладачем половину статті, злив з оригіналом
Проблема мішаного чанка в тому, що embedding-модель «бачить» весь фрагмент як один об’єкт. Вектор виходить «усередненим» між двома мовами — і він поганий для обох. Запит чистою українською не знайде цей чанк навіть якщо він релевантний, бо його вектор «відхилений» в бік англійської частини.
Мовна детекція на рівні сегментації: інструменти і підходи
Рішення — виявляти мовний склад на рівні сегментації (chunking), до індексації. Є кілька підходів:
Мовна детекція на рівні абзаців. Інструменти на кшталт langdetect (Python), lingua або fastText LangID визначають мову кожного абзацу перед тим, як його додати до чанка. Якщо документ містить абзаци різними мовами — їх розбивають на окремі чанки.
Практично: це спрацьовує для документів, де мови чергуються великими блоками (розділами). Для речень-вставок («як зазначено в оригінальному специфікації, the value should be non-negative integer») — точність нижча.
Sentence-level split по мові. Більш агресивний підхід: кожне речення перевіряється на мову, і якщо речення переключається — починається новий чанк. Це дає чистіші монолінгвальні чанки, але призводить до дуже коротких фрагментів, які втрачають контекст.
Hierarchical chunking з мовними мітками. Компромісне рішення: зберігаємо ієрархічний чанк (наприклад, цілий розділ), але додаємо в метадані інформацію про мовний склад: {primary_language: "uk", secondary_language: "en", mixed_ratio: 0.3}. При пошуку це дозволяє системі враховувати мовний фактор у ранжуванні.
Metadata-мітки мови як обхідний шлях без переіндексації
Якщо корпус уже проіндексований і переіндексація дорого коштує (час + API-витрати), metadata-мітки — практичний обхідний шлях.
Алгоритм:
1. Запустіть batch-процес мовної детекції по всіх наявних чанках
2. Додайте в metadata поля lang та lang_confidence
3. У retrieval-логіці додайте фільтр: при запиті Ukrainian → boost для lang: uk, але не виключайте lang: en (бо там може бути відповідь)
4. При запиті з технічним терміном, відсутнім в UA-результатах → автоматичний fallback на EN-чанки
Це не ідеально, але дозволяє значно покращити якість без повної переіндексації. Наш досвід показує: правильні метадані дають більше покращень, ніж перехід на кращу embedding-модель.
Підготовка корпоративної бази до мультимовної індексації
Аудит мовного складу: що де лежить і якою мовою
Перед впровадженням RAG необхідно зрозуміти, що у вас є. Звучить банально, але більшість компаній точно не знають мовний склад своєї документації.
Практичний підхід до аудиту:
1. Вивантажте список всіх документів з кожного джерела (Notion, Confluence, SharePoint)
2. Запустіть batch мовну детекцію по заголовках і першим 500 символам кожного документа
3. Збудуйте матрицю: джерело × мова × дата_оновлення × відділ
4. Виявіть «зони ризику»: документи старіші за 3 роки часто містять мову, яка не відповідає поточним стандартам компанії
Типова картина для IT-компанії 50–100 осіб: ~60% документів українською, ~30% англійською, ~10% мішані. Серед «технічних» документів пропорція зворотна: ~70% EN, ~30% UA або мішані.
Цей аудит також допомагає виявити «сміттєві» документи — застарілі, дубльовані, неповні, — які краще виключити з RAG-корпусу ще до індексації.
Правила іменування та структурування двомовних документів
Проблеми мультимовного RAG часто починаються ще до індексації — на рівні культури роботи з документами. Кілька правил, які варто запровадити:
Явна мовна мітка в назві документа. Наприклад: [UA] Регламент управління інцидентами v2.3 і [EN] Incident Management Policy v2.3. Це дозволяє як людям, так і системам одразу бачити мову.
Не змішувати мови в одному документі без потреби. Якщо потрібна двомовна версія — ліпше два окремі документи з перехресними посиланнями, ніж один гібридний.
Технічні терміни в UA-документах — зберігати оригінал в дужках. «Процес розгортання (deployment) виконується через CI/CD пайплайн» — так термін зберігається у пошукуваному вигляді для обох мовних запитів.
Notion, Confluence, SharePoint — специфіка кожного для UA+EN
Notion добре структурований, але не має нативної мовної мітки. При експорті в RAG варто використовувати назву сторінки і breadcrumbs як метадані, а мову визначати автоматично. Проблема: Notion-бази часто мають «осиротілі» сторінки без контексту — їх варто виключати.
Confluence має поле «Space» і «Label», які можна використовувати як мовні мітки. Якщо у вас є окремі простори для UA і EN документів — налаштуйте відповідні фільтри при індексації. Confluence також добре підтримує вкладені сторінки, що дозволяє реалізувати ієрархічний chunking.
SharePoint — найскладніший варіант для RAG. Часто містить документи у форматах .docx, .xlsx, .pptx, які потребують конвертації. Старі документи (до 2015 року) можуть бути у форматах з поганою текстовою екстракцією. Для SharePoint обов’язково реалізуйте document quality scoring — відокремте чисті текстові документи від сканованих PDF.
Юридичний контекст: мова відповіді та вимоги українського законодавства
Закон про державну мову і корпоративні AI-системи
Закон України «Про забезпечення функціонування української мови як державної» (№ 2704-VIII) встановлює вимоги до мови обслуговування у сфері послуг і ділового спілкування. Хоча закон прямо не регулює AI-системи (на момент написання статті), його дух і практика правозастосування однозначні: обслуговування клієнтів і співробітників має вестися українською мовою.
Для корпоративного AI-асистента це означає: – Відповіді системи мають бути українською незалежно від мови джерельного документа – Інтерфейс і помилки системи — українською – Якщо необхідне цитування EN-документа — цитата може бути EN, але пояснення та контекст — UA
Ігнорування цього аспекту може стати проблемою при взаємодії з держорганами, аудиторами або при публічному позиціонуванні.
Як налаштувати RAG щоб відповідь завжди була українською
Технічне рішення — явна мовна інструкція в системному промпті LLM. Це одна з найпростіших, але найчастіше пропущених деталей.
Базовий підхід:
Системний промпт: "Ти корпоративний AI-асистент компанії [Назва].
Завжди відповідай українською мовою, навіть якщо знайдені документи
англійською. При цитуванні технічних термінів з EN-документів
зберігай оригінальний термін в дужках після українського відповідника.
Приклад: 'Процес розгортання (deployment) виконується автоматично.'"
Але системного промпту недостатньо — потрібен language-fallback на рівні retrieval:
- Якщо система знаходить лише EN-чанки → не відмовлятися від відповіді, а генерувати UA-відповідь на основі EN-документа з явним зазначенням джерела
- Якщо LLM «перемикається» на EN у відповіді → додати постпроцесинг з мовною перевіркою
- Логувати всі відповіді з мовою відмінною від UA → ручний аудит щотижня
Кейс: корпоративний AI-асистент для IT-компанії з 80 співробітниками
Вихідна ситуація: Notion UA + Confluence EN + Google Docs мішані
Компанія надавала послуги з розробки ПЗ для EU-клієнтів. 80 співробітників, три офіси. Щодня до HR-відділу та тімлідів надходило 40–60 типових запитів: відпустки, лікарняні, процедури онбордингу, технічні стандарти, налаштування робочих середовищ.
Мовний склад бази: – Notion (HR, процеси): ~200 сторінок, 90% UA, 10% EN (шаблони контрактів) – Confluence (технічна документація): ~800 сторінок, 75% EN, 25% UA (коментарі і пояснення) – Google Docs (комерційні матеріали): ~150 документів, 50/50
Перша спроба з базовим RAG на text-embedding-ada-002 (попередня модель OpenAI) дала 42% точних відповідей на тестовій вибірці з 50 запитів. З них 15 відповідей взагалі не знайшли релевантного документа через мовний бар’єр.
Що зробили, яку модель обрали, як вирішили мішані чанки
Команда провела аудит і виявила три основні проблеми:
Проблема 1: Confluence-сторінки з мішаними мовами. 30% сторінок Confluence містили UA-заголовки з EN-тілом або навпаки. Рішення: sentence-level мовна детекція при chunking, окремі чанки для UA і EN блоків, metadata з полем lang.
Проблема 2: Технічні терміни у UA-запитах. Розробники питали «як налаштувати docker-compose для локальної розробки» — і система не знаходила EN-документ «Local Development Setup Guide» (де слово «docker-compose» було, але контекст читався як EN). Рішення: hybrid retrieval з BM25 для точного матчу технічних термінів.
Проблема 3: Відповіді частково англійською. LLM «переключався» при цитуванні EN-документів. Рішення: явна інструкція в промпті з прикладами правильного формату.
Обрана модель: text-embedding-3-large для основного корпусу + BGE-M3 sparse mode для технічної термінології у гібридному retrieval.
Результат: 60% запитів до HR закрито без живого оператора
Через 6 тижнів після впровадження оновленої системи:
- Точність відповідей на тестовій вибірці: 87% (проти 42% до оптимізації)
- Відсоток запитів до HR, закритих AI-асистентом: 60% (до впровадження — 0%)
- Середній час відповіді: 4 секунди (проти 2–4 годин для відповіді HR-менеджера)
- Навантаження на тімлідів: -30% технічних запитів перенаправлено на AI-асистента
Компанія оцінила збережений час HR-менеджера і тімлідів у 25–30 годин на тиждень. При вартості часу фахівця 800–1000 грн/год — це 20 000–30 000 грн щомісяця.
Другий сценарій — юридична фірма з 25 юристами, що обслуговує міжнародних клієнтів. Документи: UA-процесуальні документи + EN-контракти та кореспонденція з іноземними партнерами. Тут мультимовний RAG дав змогу юристу задати запит «яка практика компенсації за порушення строків поставки в англійських контрактах?» і отримати відповідь на основі реальних EN-контрактів компанії з UA-поясненням. До впровадження цей пошук займав 1–2 години роботи асистента.
Часті помилки при запуску мультимовного RAG
Помилка 1 — одна embedding-модель для всього корпусу без перевірки UA-якості
Найпоширеніша помилка — взяти популярну модель (наприклад, text-embedding-ada-002 або будь-яку з «топ рейтингів») і впровадити її без тестування на реальному UA-контенті.
Симптоми: система добре відповідає на EN-запити, але «не знаходить» релевантних UA-документів. Або знаходить, але ранжує неправильно.
Рішення: завжди тестуйте на реальних запитах і реальних документах перед вибором моделі. Мінімальна тестова вибірка — 30–50 запитів різними мовами з відомими правильними відповідями.
Помилка 2 — ігнорування мовного складу при chunking
Стандартний підхід «розбий кожен документ на 512 токенів з overlap 50» не враховує мовні межі. Результат — мішані чанки з поганими векторами.
Практична порада: перед chunking завжди виконуйте мовний аудит документа. Для документів, де мови чергуються на рівні абзаців — використовуйте мовні межі як пріоритетні точки розбивки.
Важливий нюанс: не варто розбивати чанки по кожному реченню різної мови — це знищить контекст. Розумна стратегія — зберігати абзац або підрозділ як мінімальну одиницю, але не змішувати кілька абзаців різними мовами в один чанк.
Помилка 3 — відсутність language-fallback у промпті LLM
Навіть при правильній індексації і retrieval, якщо в системному промпті немає явної інструкції щодо мови відповіді — LLM буде «переключатися» на EN при роботі з EN-документами.
Це особливо помітно при цитуванні. Модель «думає», що передає точнішу інформацію, якщо цитує оригінал — і це правда з технічної точки зору. Але для кінцевого користувача, який чекає на UA-відповідь, це виглядає як баг.
Обов’язкові елементи промпту: – Явна вказівка мови відповіді – Інструкція щодо технічних термінів (зберігати EN-термін у дужках) – Зразок правильного формату відповіді
Також варто реалізувати постпроцесинг: після отримання відповіді від LLM автоматично перевіряти мову і логувати випадки, коли відповідь не відповідає очікуваній мові.
FAQ — часті запитання
Чи потрібно переводити всі документи в одну мову перед індексацією?
Ні — і це один із головних міфів навколо мультимовного RAG. Переклад усього корпусу перед індексацією (підхід translate-then-index) виправданий лише в окремих сценаріях: коли у вас дуже мало документів, або коли точність перекладу критично важлива і ви готові перевіряти кожен переклад вручну. Для більшості компаній це надлишкова витрата: перекласти 500+ документів, підтримувати обидві версії в актуальному стані при оновленнях — дорого і непрактично. Сучасні мультимовні embedding-моделі (text-embedding-3-large, BGE-M3) дозволяють індексувати оригінальні документи і добре працювати з міжмовними запитами без попереднього перекладу.
Яка embedding-модель найкраще підходить для українського тексту?
Однозначної відповіді немає — залежить від вашого корпусу і бюджету. text-embedding-3-large від OpenAI — найпростіший старт з хорошою якістю для загальних запитів. BGE-M3 від BAAI — найкращий варіант для on-premise і великих корпусів зі специфічною термінологією завдяки hybrid retrieval (dense + sparse). Cohere Embed Multilingual v3 — хороший варіант для хмарних рішень якщо ви вже в екосистемі Cohere. Головне правило: тестуйте на реальному контенті перед фінальним вибором. 30–50 запитів з відомими відповідями — мінімальний тест.
Що таке language bias і як його уникнути?
Language bias (мовний зсув) — це тенденція LLM відповідати мовою знайденого документа, а не мовою запиту користувача. Наприклад: запит українською, знайдений документ англійською — модель «перемикається» на EN при формулюванні відповіді. Уникнути можна трьома способами: (1) явна мовна інструкція в системному промпті; (2) few-shot приклади правильного формату відповіді в промпті; (3) постпроцесинг із мовною перевіркою і автоматичним переформулюванням якщо мова не відповідає очікуваній. Найефективніший підхід — комбінувати всі три.
Чи можна використовувати RAG якщо частина документів — скановані PDF?
Можна, але зі застереженнями. Скановані PDF потребують OCR (оптичне розпізнавання символів) перед індексацією. Якість OCR критично впливає на якість RAG. Якщо OCR дає помилки (особливо для українських літер з нестандартними шрифтами) — краще виключити ці документи з основного корпусу і обробляти окремо. Практичний підхід: document quality scoring — автоматично класифікуйте документи на «чисті» (текстові PDF, docx) і «проблемні» (скановані, низька якість OCR). Для проблемних — або ручна верифікація, або виключення з RAG.
Скільки коштує впровадження мультимовного RAG для компанії 50–100 осіб?
Вартість залежить від розміру корпусу, вимог до on-premise, обраних моделей і складності інтеграцій. Орієнтовно для компанії 50–100 осіб з базою 500–2000 документів: хмарний варіант (OpenAI embeddings + GPT-4o-mini для відповідей) — $200–500/місяць операційних витрат після одноразового впровадження вартістю від 150 000–300 000 грн залежно від складності. On-premise варіант — вищі початкові витрати (сервер, GPU якщо потрібен), нижчі операційні. Для точного розрахунку під вашу ситуацію — потрібен аудит документаційної бази.
Як RAG справляється з термінами, які є і в UA, і в EN корпусі в різному написанні?
Це проблема термінологічної варіативності — «деплой» vs «deployment» vs «розгортання» — всі три можуть зустрічатися у вашій базі. Рішення: (1) термінологічний глосарій у метаданих або як окремий документ, який система завжди включає в контекст; (2) query expansion — при обробці запиту автоматично додавати синоніми і мовні варіанти; (3) hybrid retrieval — BM25-компонент знайде точне слово, semantic-компонент знайде семантичні варіанти. Комбінація двох підходів закриває більшість випадків без ручного ведення словника.
Висновок і наступний крок
Мультимовна база знань — не виняткова ситуація, а норма для українського бізнесу в 2026 році. Технічна документація англійською, регламенти українською, а між ними — ціла мережа документів, де мови перемежовуються в одному абзаці. Базова RAG-архітектура з цим не впорається без спеціального налаштування.
Три ключові принципи, які вирішують 80% проблем:
- Правильна embedding-модель для UA+EN корпусу — text-embedding-3-large або BGE-M3 залежно від вимог
- Hybrid retrieval (семантичний + ключове-слівний) — обов’язковий для спеціалізованих доменів
- Явна мовна логіка на рівні chunking, метаданих і системного промпту
Якщо ви вже маєте корпоративну базу знань і хочете зрозуміти, наскільки вона «готова» до RAG-індексації — почніть з аудиту мовного складу. Це займає кілька годин, але дає чітку картину, де проблеми і що потрібно виправити перед впровадженням.
Детальніше про вибір векторної бази даних для зберігання вбудовувань — у статті Векторні бази даних для бізнесу. А про підготовку корпоративних документів до індексації — в окремому гайді Як підготувати корпоративні документи для RAG.
Якщо хочете зрозуміти, які проблеми є саме у вашій документаційній базі — замовте безкоштовний AI-аудит. За 5 днів ми проаналізуємо мовний склад, якість документів і визначимо оптимальну архітектуру для вашого корпусу. Пілот RAG-системи — від 3 тижнів з фіксованою вартістю.